

このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、英語版 を参照してください。
チャットボットは、ユーザーがチャットインターフェースを通じてモデルと対話する会話型アプリです。
ツール呼び出しやマルチステップワークフローを必要としないが、やり取りのある対話が有効なタスクに使用します。たとえば、チームのナレッジベースに基づいた社内 Q&A アシスタントの構築に適しています。
チャットボットは会話ごとに最大 500 メッセージまたは 2,000 token の履歴を保持します。いずれかの上限を超えた場合、新しいメッセージのために古いメッセージから順に削除されます。
チャットボットは会話オープナー、フォローアップ提案などのオプション機能もサポートしています。詳細は アプリツールキット を参照してください。
設定#
プロンプトの作成#
プロンプトは、モデルに何をすべきか、どのように応答すべきか、どのような制約に従うべきかを伝えます。会話全体を通じてモデルの振る舞いを形作るため、一回限りのタスクではなく、一貫したペルソナを定義するものと考えてください。
効果的なプロンプトを書くためのヒント:
-
ペルソナを定義する:モデルが誰として振る舞い、どのようなトーンを使用すべきかを記述します。
-
出力形式を指定する:期待する構造、長さ、スタイルを記述します。
-
制約を設定する:モデルが避けるべきことや従うべきルールを伝えます。
変数を使った動的プロンプトの作成#
毎回プロンプトを書き直すことなく、異なるユーザーやコンテキストにチャットボットを適応させるには、変数を追加して必要な情報を事前に収集します。
変数はプロンプト内のプレースホルダーです。各変数は入力フィールドとして表示され、ユーザーが会話開始前に入力し、その値が実行時にプロンプトに挿入されます。ユーザーは会話中に変数の値を更新することもでき、プロンプトはそれに応じて調整されます。
たとえば、オンボーディングアシスタントでは role と language を使って回答をカスタマイズできます:
プロンプトの作成中に / と入力し、変数を新規追加 を選択すると、名前付きプレースホルダーをすばやく挿入できます。詳細は後で Variables セクションで設定できます。
期待する入力に合った変数タイプを選択してください:
最大 256 文字まで入力可能です。名前、メールアドレス、タイトルなど、1 行に収まる短いテキスト入力に使用します。
長さ制限のない長文テキストを入力できます。詳細な説明のための複数行テキストエリアをユーザーに提供します。
事前定義されたオプションを含むドロップダウンメニューを表示します。
入力を数値のみに制限します。数量、評価、ID、または数学的処理が必要なデータに最適です。
シンプルな「はい/いいえ」のオプションを提供します。ユーザーがチェックボックスをオンにすると出力は true、それ以外は false になります。確認や二択が必要なケースに使用します。
ユーザーからの入力ではなく、実行時に外部 API から変数の値を取得します。
ライブ気象条件やデータベースレコードなど、外部ソースからの動的データがプロンプトに必要な場合に使用します。詳細は カスタム API を参照してください。
ラベル名 は、エンドユーザーに各入力フィールドとして表示される名前です。
AI でプロンプトを生成・改善する#
何から始めればよいかわからない場合や、既存のプロンプトを改善したい場合は、生成 をクリックして LLM にドラフトを作成させましょう。
ゼロから望む内容を記述するか、current_prompt を参照して改善点を指定します。より的確な結果を得るには、理想的な出力 にサンプルを追加してください。
生成のたびにバージョンとして保存されるため、自由に実験してロールバックできます。
独自データに基づいた回答#
一般的な知識ではなく独自のデータに基づいてモデルの回答を生成するには、ナレッジベースを追加します。
ユーザーがメッセージを送信するたびに、そのメッセージが検索クエリとしてナレッジベースから関連コンテンツを取得し、モデルへのコンテキストとしてプロンプトに挿入されます。
アプリレベルの検索設定#
検索結果の処理方法を微調整するには、検索設定 をクリックします。
検索設定にはナレッジベースレベルとアプリレベルの 2 つのレイヤーがあります。
2 つの連続するフィルターと考えてください。ナレッジベース設定が結果の初期プールを決定し、アプリ設定がさらに結果をリランクまたはプールを絞り込みます。
-
リランク設定
-
ウェイト設定
リランク時のセマンティック類似度とキーワードマッチングの相対的な重みです。セマンティックの重みを高くすると意味的な関連性が重視され、キーワードの重みを高くすると完全一致が重視されます。
ウェイト設定は、追加されたすべてのナレッジベースが 高品質 モードでインデックスされている場合のみ利用可能です。
-
リランクモデル
クエリとの関連性に基づいてすべての結果を再スコアリングし、並べ替えるリランクモデルです。
Noteマルチモーダルのナレッジベースが追加されている場合は、マルチモーダルリランクモデル(Vision タグ付き)も選択してください。そうしないと、検索された画像がリランクと最終出力から除外されます。
-
-
Top K
リランク後に返す上位結果の最大数です。
リランクモデルが選択されている場合、この値はモデルの最大入力容量(モデルが一度に処理できるテキスト量)に基づいて自動的に調整されます。
-
スコアしきい値
返される結果の最小類似度スコアです。このしきい値を下回る結果は除外されます。厳密な関連性にはより高いしきい値を、より広範なマッチングにはより低いしきい値を使用してください。
特定ドキュメント内の検索#
デフォルトでは、検索はナレッジベース全体を対象とします。検索を特定のドキュメントに制限するには、手動または自動のメタデータフィルタリングを有効にします。
これにより検索精度が向上します。特にナレッジベースが大規模な場合や、異なるコンテキストのコンテンツが含まれている場合に有効です。
ドキュメントメタデータの作成と管理については、メタデータを参照してください。
マルチモーダル入力の処理#
エンドユーザーがファイルをアップロードできるようにするには、対応するマルチモーダル機能を持つモデルを選択します。モデルがサポートしている場合、関連するファイルタイプのトグル(ビジョン、音声、ドキュメント)が表示され、必要に応じて有効にできます。
モデルのサポートするモダリティはタグで簡単に確認できます。
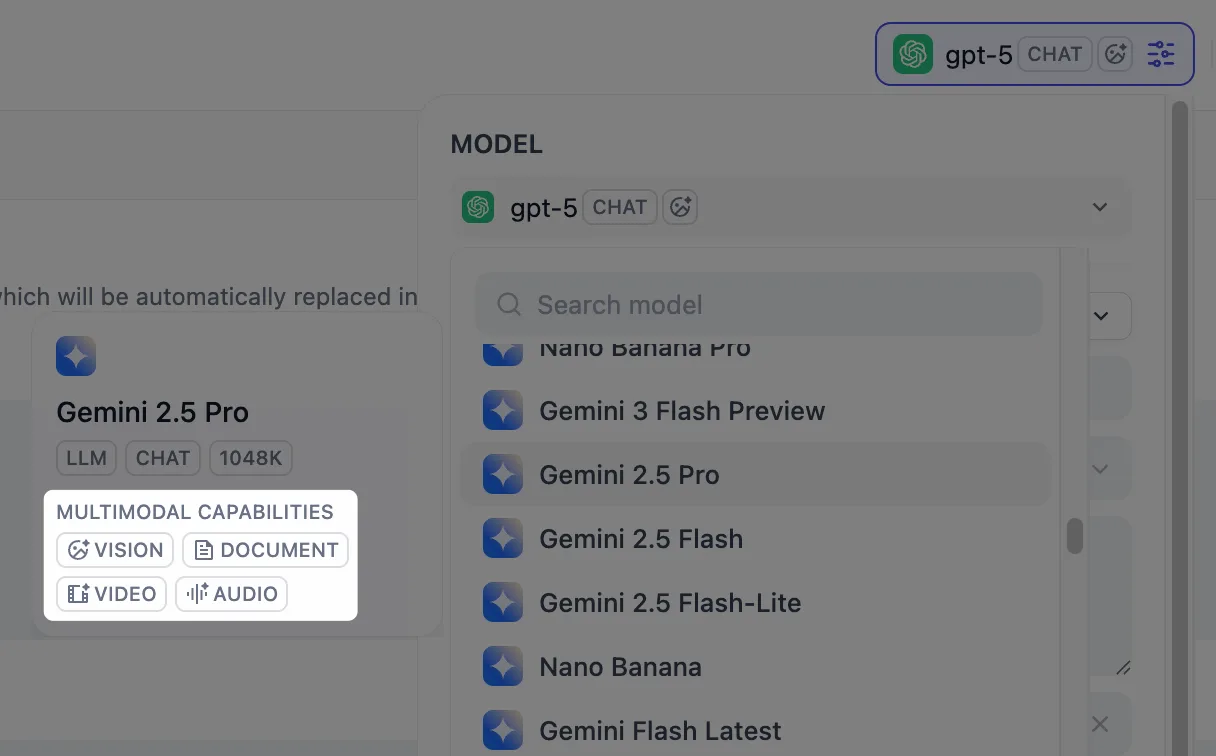
ビジョン の下にある 設定 をクリックして、ファイルの受け入れと処理方法を設定します。アップロード設定は、有効なすべてのファイルタイプに適用されます。
-
解像度: 画像 処理のみの詳細レベルを制御します。
-
高:複雑な画像ではより高い精度が得られますが、より多くの token を使用します
-
低:シンプルな画像では、より少ない token で高速に処理します
-
-
アップロード方法:ユーザーがデバイスからアップロード、URL の貼り付け、またはその両方を選択できます。
-
アップロード制限:ユーザーが 1 メッセージあたりにアップロードできるファイルの最大数です。
ファイルサイズの上限は、以下の環境変数で調整します。
UPLOAD_IMAGE_FILE_SIZE_LIMIT(デフォルト:10 MB)UPLOAD_FILE_SIZE_LIMIT(デフォルト:15 MB)UPLOAD_AUDIO_FILE_SIZE_LIMIT(デフォルト:50 MB)
詳細は 環境変数 を参照してください。
デバッグとプレビュー#
右側のプレビューパネルで、チャットボットをリアルタイムにテストできます。タスクに最適なモデルを選択し、メッセージを入力して送信すると、モデルがどのように応答するかを確認できます。
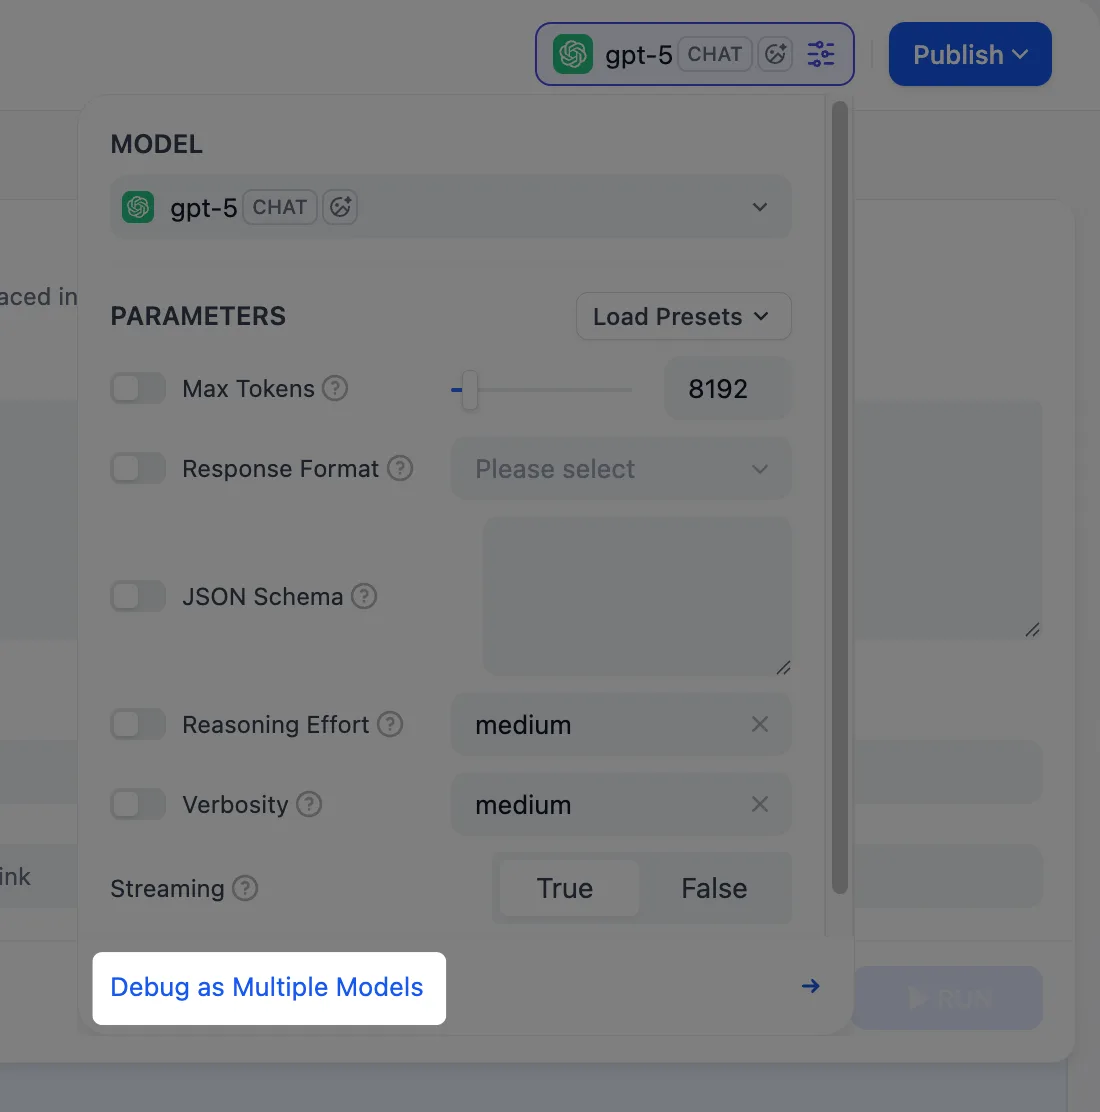
モデルを選択した後、パラメータを調整して応答の生成方法を制御できます。利用可能なパラメータとプリセットはモデルによって異なります。
異なるモデル間で出力を比較するには、複数モデルでデバッグ をクリックして最大 4 つのモデルを同時に実行できます。
公開する#
結果に満足したら、公開する をクリックしてアプリを公開します。公開オプションの全一覧は公開するを参照してください。