

このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、英語版 を参照してください。
チャンキングモードを選択した後、次のステップは構造化されたコンテンツのインデックス方法を定義することです。
インデックス方法の選択#
検索エンジンが効率的なインデックスアルゴリズムを使用してユーザーのクエリに最も関連する検索結果をマッチングするのと同様に、選択したインデックス方法は LLM の検索効率とナレッジベースコンテンツに対する回答の正確性に直接影響します。
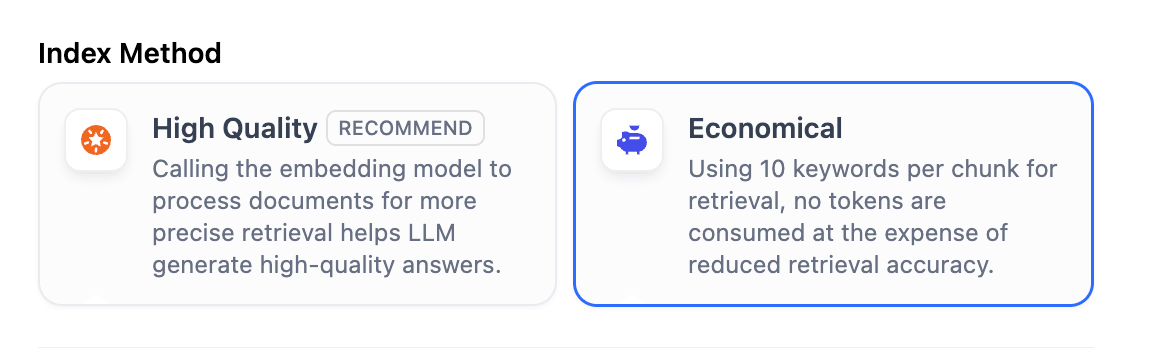
ナレッジベースでは、高品質 とエコノミー の 2 種類のインデックス方法を提供しており、それぞれ異なる検索設定オプションがあります。
高品質インデックス方法で作成されたナレッジベースは、後からエコノミーに切り替えることはできません。
高品質インデックス方法では、埋め込みモデルを使用してコンテンツチャンクをベクトル表現に変換します。この処理を埋め込み(embedding)と呼びます。
これらのベクトルは多次元空間上の座標のようなものです。2 つの点の距離が近いほど、それらの意味が近いことを示しています。このしくみにより、システムは単なるキーワード一致ではなく、意味的な類似性に基づいて関連情報を検索できます。
これらのベクトルはワークスペースのナレッジストレージを消費します。プランごとの容量と上限到達時の動作は ナレッジベースのデータストレージ制限 を参照してください。
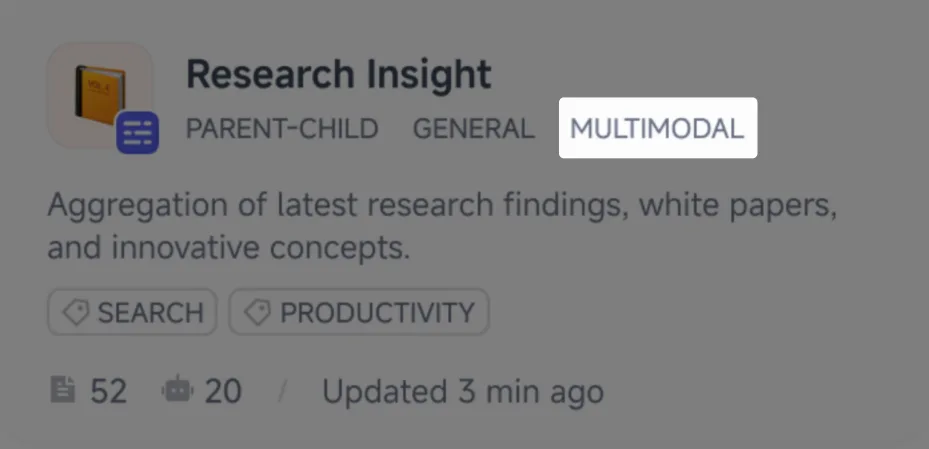
クロスモーダル検索(テキストと画像を意味的関連性に基づいて取得)を有効にするには、マルチモーダル埋め込みモデル(Vision アイコン付き)を選択してください。ドキュメントから抽出された画像もベクトル化され、検索用にインデックス化されます。
このような埋め込みモデルを使用するナレッジベースは、カード上で Multimodal とラベル付けされます。
高品質インデックス方法では、ベクトル検索、全文検索、ハイブリッド検索の 3 つの検索戦略がサポートされています。詳細は 検索設定の指定 をご覧ください。
各チャンクで 10 個のキーワードを使用して検索し、検索精度は下がりますがトークンを消費しません。検索されたブロックに対しては、逆引きインデックス方式のみで最も関連性の高いブロックを選択します。
エコノミーインデックス方法のパフォーマンスが期待に沿わない場合は、ナレッジ設定ページで高品質インデックス方法にアップグレードできます。
検索設定の指定#
ナレッジベースはユーザーのクエリを受け取った後、事前設定された検索方法に従って既存のドキュメントを検索し、高度に関連するコンテンツチャンクを抽出します。これらのチャンクは LLM に不可欠なコンテキストを提供し、最終的に回答の正確性と信頼性に影響を与えます。
一般的な検索方法には以下があります:
- ベクトル類似度に基づく意味検索 - テキストチャンクとクエリをベクトルに変換し、類似度スコアリングでマッチングします。
- 逆引きインデックス(標準的な検索エンジン技術)を使用したキーワードマッチング。両方の方法が Dify のナレッジベースでサポートされています。
両方の検索方法が Dify のナレッジベースでサポートされています。利用可能な具体的な検索オプションは、選択したインデックス方法によって異なります。
高品質
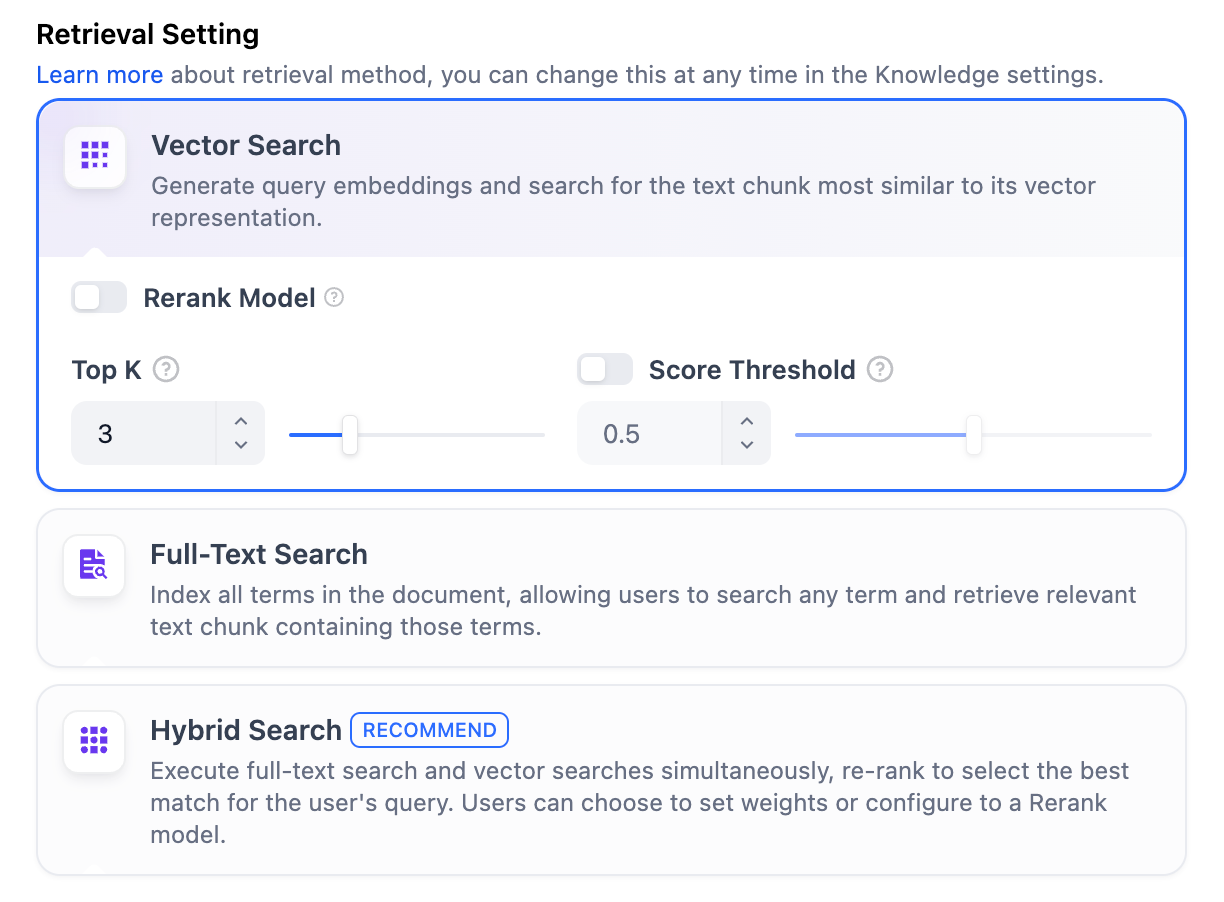
高品質 インデックス方法では、Dify はベクトル検索、全文検索、ハイブリッド検索 の 3 つの検索設定を提供しています。
ベクトル検索
定義:ユーザーの質問をベクトル化してクエリベクトルを生成し、ナレッジベース内の対応するテキストベクトルと比較して、最も近いチャンクを見つけます。
ベクトル検索設定:
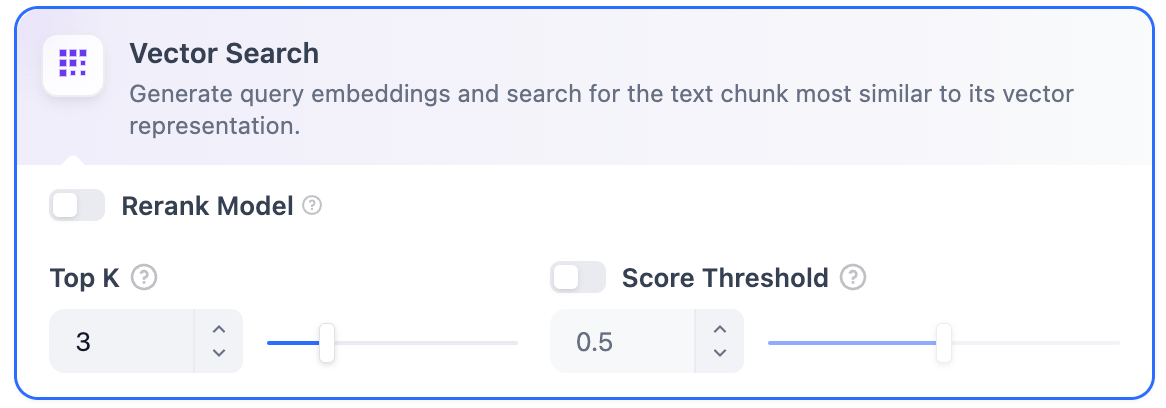
Rerank モデル:デフォルトでは無効です。有効にすると、サードパーティの Rerank モデルがベクトル検索によって返されたテキストチャンクを並べ替えて結果を最適化します。これにより、LLM がより正確な情報にアクセスし、出力品質を向上させることができます。このオプションを有効にする前に、統合 > モデルプロバイダーに移動して Rerank モデルの API キーを設定してください。
選択した埋め込みモデルがマルチモーダルの場合は、マルチモーダル Rerank モデル(Vision アイコン付き)も選択してください。そうでない場合、検索された画像はリランキングと検索結果から除外されます。
この機能を有効にすると、Rerank モデルのトークンが消費されます。詳細については、関連するモデルの価格ページを参照してください。
TopK:ユーザーのクエリに最も類似していると判断されたテキストチャンクの取得数を決定します。選択したモデルのコンテキストウィンドウに基づいてチャンク数を自動的に調整します。デフォルト値は 3 で、値が高いほど多くのテキストチャンクが呼び出されます。
Score しきい値:チャンクが取得されるために必要な最小類似度スコアを設定します。このスコアを超えるチャンクのみが取得されます。デフォルト値は0.5 です。しきい値が高いほど類似度の要求が高くなり、取得されるチャンク数が少なくなります。
TopK と Score 設定は Rerank フェーズでのみ有効です。したがって、これらの設定を適用するには、Rerank モデルを追加して有効にする必要があります。
全文検索
定義:ドキュメント内のすべての用語をインデックス化し、ユーザーが任意の用語をクエリして、それらの用語を含むテキストフラグメントを返すことができます。
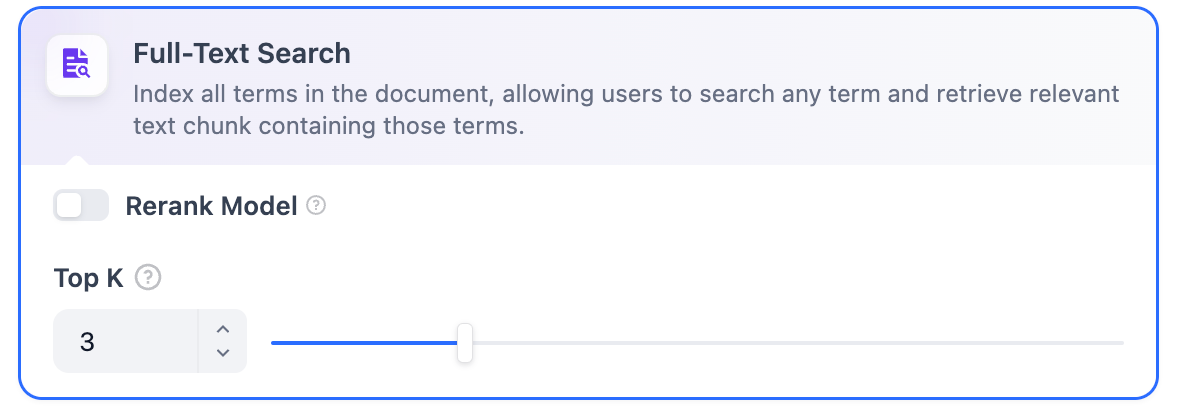
Rerank モデル:デフォルトでは無効です。有効にすると、サードパーティの Rerank モデルが全文検索によって返されたテキストチャンクを並べ替えて結果を最適化します。これにより、LLM がより正確な情報にアクセスし、出力品質を向上させることができます。このオプションを有効にする前に、統合 > モデルプロバイダーに移動して Rerank モデルの API キーを設定してください。
選択した埋め込みモデルがマルチモーダルの場合は、マルチモーダル Rerank モデル(Vision アイコン付き)も選択してください。そうでない場合、検索された画像はリランキングと検索結果から除外されます。
この機能を有効にすると、Rerank モデルのトークンが消費されます。詳細については、関連するモデルの価格ページを参照してください。
TopK:ユーザーのクエリに最も類似していると判断されたテキストチャンクの取得数を決定します。選択したモデルのコンテキストウィンドウに基づいてチャンク数を自動的に調整します。デフォルト値は 3 で、値が高いほど多くのテキストチャンクが呼び出されます。
Score しきい値:チャンクが取得されるために必要な最小類似度スコアを設定します。このスコアを超えるチャンクのみが取得されます。デフォルト値は0.5 です。しきい値が高いほど類似度の要求が高くなり、取得されるチャンク数が少なくなります。
TopK と Score 設定は Rerank フェーズでのみ有効です。したがって、これらの設定を適用するには、Rerank モデルを追加して有効にする必要があります。
ハイブリッド検索
定義:全文検索とベクトル検索を同時に実行し、リオーダリングステップを含めて、ユーザーのクエリに基づいて両方の検索結果から最もマッチする結果を選択します。
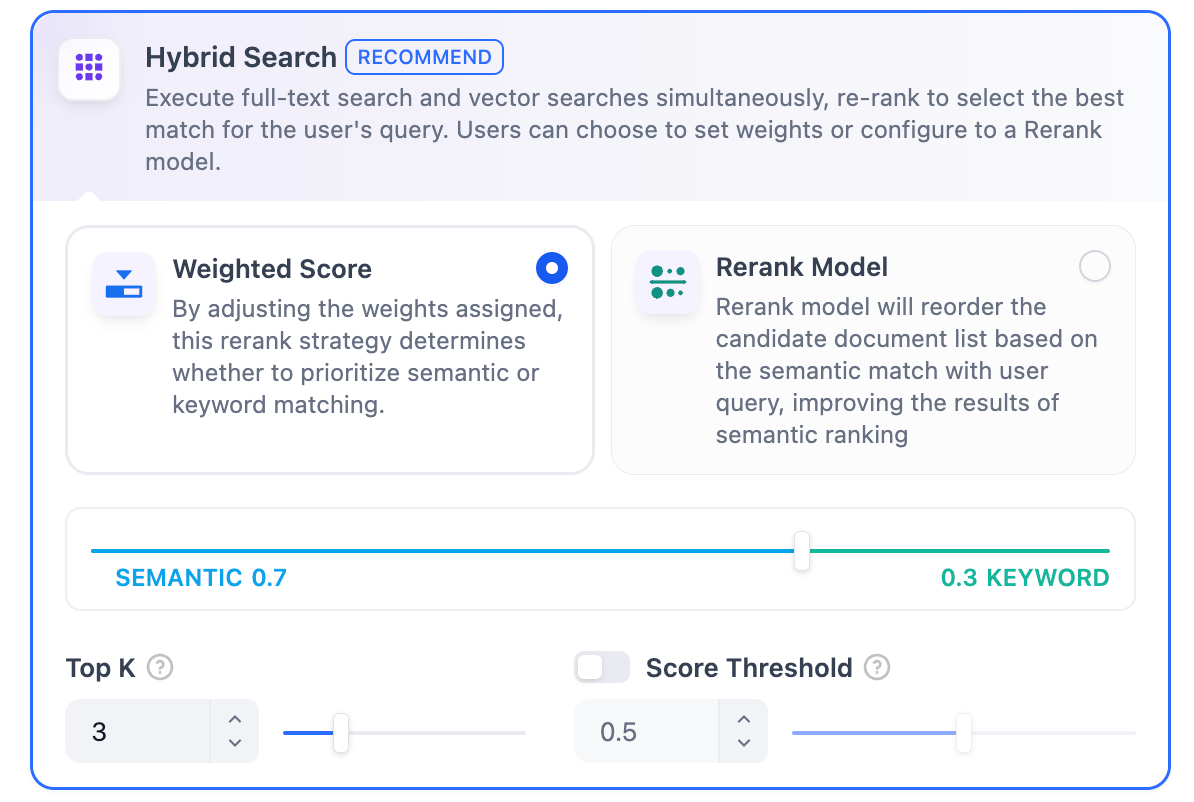
このモードでは、Rerank モデル API を設定せずに 「重み付け設定」 を指定するか、Rerank モデル を有効にして検索を行うことができます。
-
重み付け設定
この機能により、ユーザーは意味優先度とキーワード優先度にカスタム重みを設定できます。キーワード検索はナレッジベース内での全文検索を指し、意味検索はナレッジベース内でのベクトル検索を指します。
-
意味値を 1 にする
意味検索モードのみを有効にします。埋め込みモデルを活用することで、クエリに含まれる正確な用語がナレッジベースになくても、ベクトル距離を計算することで検索の深度を高め、関連コンテンツを返すことができます。また、多言語コンテンツを処理する場合、意味検索は異なる言語間の意味をキャプチャし、より正確なクロス言語検索結果を提供できます。
-
キーワード値を 1 にする
キーワード検索モードのみを有効にします。ナレッジベース内で入力テキストとの完全一致を実行し、ユーザーが正確な情報や用語を知っているシナリオに適しています。この方法は消費する計算リソースが比較的少なく、大量のドキュメントを含むナレッジベース内での迅速な検索に適しています。
-
キーワードと意味の重みをカスタマイズする
意味検索またはキーワード検索のみを有効にするだけでなく、柔軟なカスタム重み設定を提供しています。両方の方法の重みを継続的に調整して、ビジネスシナリオに合った最適な重み比率を見つけることができます。 Rerank モデル
デフォルトでは無効です。有効にすると、サードパーティの Rerank モデルがハイブリッド検索によって返されたテキストチャンクを並べ替えて結果を最適化します。これにより、LLM がより正確な情報にアクセスし、出力品質を向上させることができます。このオプションを有効にする前に、統合 > モデルプロバイダーに移動して Rerank モデルの API キーを設定してください。
Note選択した埋め込みモデルがマルチモーダルの場合は、マルチモーダル Rerank モデル(Vision アイコン付き)も選択してください。そうでない場合、検索された画像はリランキングと検索結果から除外されます。
この機能を有効にすると、Rerank モデルのトークンが消費されます。詳細については、関連するモデルの価格ページを参照してください。
-
「重み付け設定」 と 「Rerank モデル」 設定では、以下のオプションがサポートされています:
TopK:ユーザーのクエリに最も類似していると判断されたテキストチャンクの取得数を決定します。選択したモデルのコンテキストウィンドウに基づいてチャンク数を自動的に調整します。デフォルト値は 3 で、値が高いほど多くのテキストチャンクが呼び出されます。
Score しきい値:チャンクが取得されるために必要な最小類似度スコアを設定します。このスコアを超えるチャンクのみが取得されます。デフォルト値は0.5 です。しきい値が高いほど類似度の要求が高くなり、取得されるチャンク数が少なくなります。
エコノミー
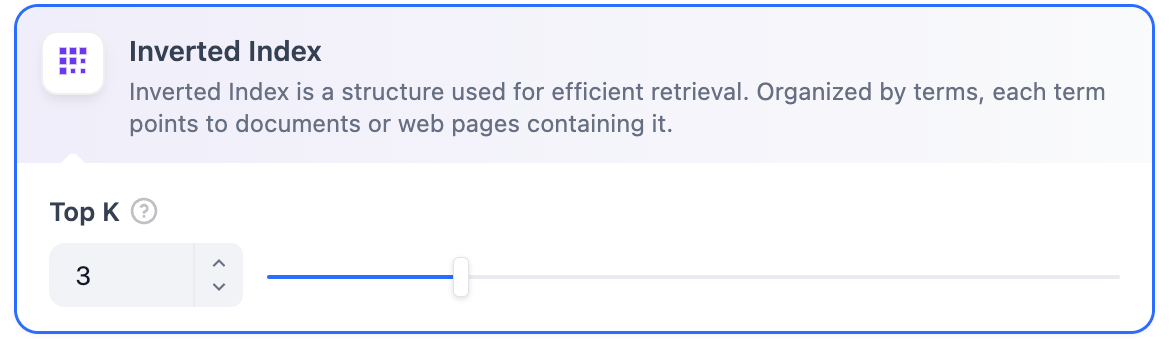
エコノミーインデックス モードでは、逆引きインデックスアプローチのみが利用可能です。逆引きインデックスはドキュメント内のキーワードを高速に検索するために設計されたデータ構造で、オンライン検索エンジンでよく使用されています。逆引きインデックスはTopK 設定のみをサポートしています。
TopK:ユーザーのクエリに最も類似していると判断されたテキストチャンクの取得数を決定します。選択したモデルのコンテキストウィンドウに基づいてチャンク数を自動的に調整します。デフォルト値は 3 で、値が高いほど多くのテキストチャンクが呼び出されます。
リファレンス#
検索設定を指定した後、以下のドキュメントを参照して、さまざまなシナリオでのキーワードとコンテンツチャンクのマッチング状況を確認できます。
ナレッジベース検索のテストと引用方法を学ぶ