

このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、英語版 を参照してください。
はじめに#
Dify では、Web ページを LLM(大規模言語モデル)が読み取れる Markdown 形式に変換するためのクローラーツール、例えば Jina を利用できます。
最近、wordware.aiが、クローラーを使ってソーシャルメディアをデータ収集し、LLM 分析用の面白いアプリケーションを開発できることを教えてくれました。このアプリケーションは、特にデータ分析や洞察を提供するために設計されています。
しかし、かつて Twitter として知られていた「X」は、2023 年 2 月 2 日以降、無料の API アクセスを提供しなくなり、それに続いてクローリング対策を強化しました。そのため、Jina のようなツールは X のコンテンツに直接アクセスすることができなくなっています。
2023 年 2 月 9 日から、Twitter API の無料アクセスは終了し、v2 および v1.1 のサポートも行われなくなります。代わりに、有料の基本プランが提供されます。 🧵
— Developers (@XDevelopers) February 2, 2023
幸いなことに、Dify には HTTP ツールがあり、これを使用して外部のクローリングツールに HTTP リクエストを送信できます。それでは、始めていきましょう!
前提条件#
Crawlbase の登録#
Crawlbase は、ビジネスや開発者向けに設計されたデータクローリングとスクレイピングのプラットフォームです。このツールを使うことで、X、Facebook、Instagram などのソーシャルメディアプラットフォームからデータを収集できます。
登録は以下のリンクから行えます:crawlbase.com
Dify へのサインイン#
ブラウザで Dify を開いてサインインします。このチュートリアルを進めるには、起動中の Dify インスタンスにアクセスできる必要があります。
LLM プロバイダーの設定#
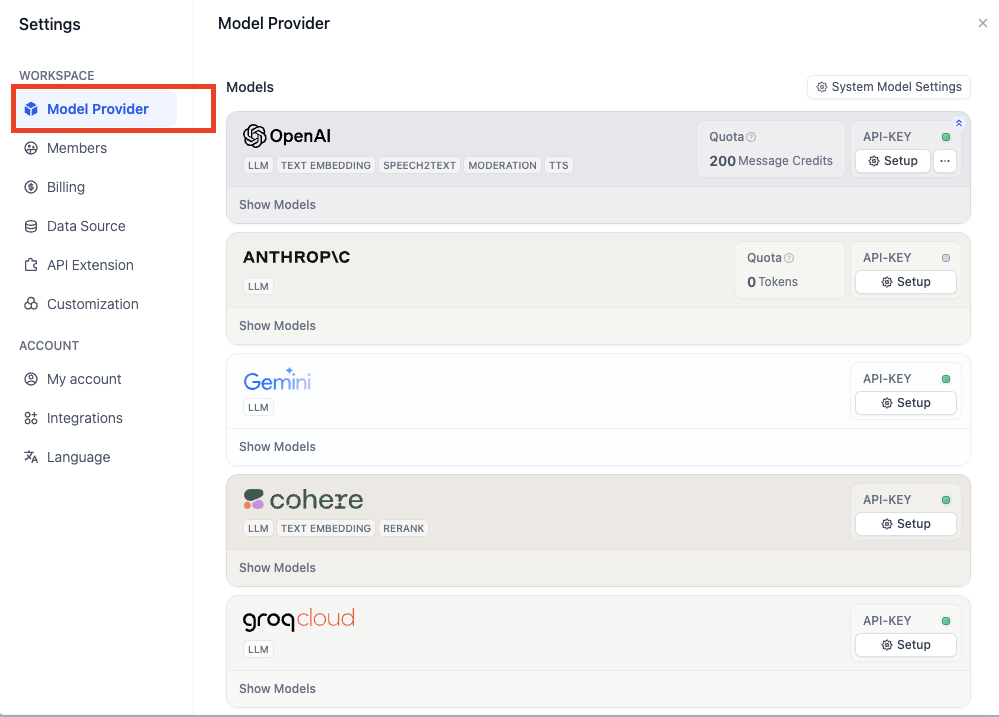
少なくとも 1 つのモデルプロバイダーの認証情報が必要です(OpenAI の API キーや、Ollama などのローカルプロバイダーなど)。統合 > モデルプロバイダー で設定してください:
Chatflow の作成#
それでは、Chatflow の作成を始めましょう。
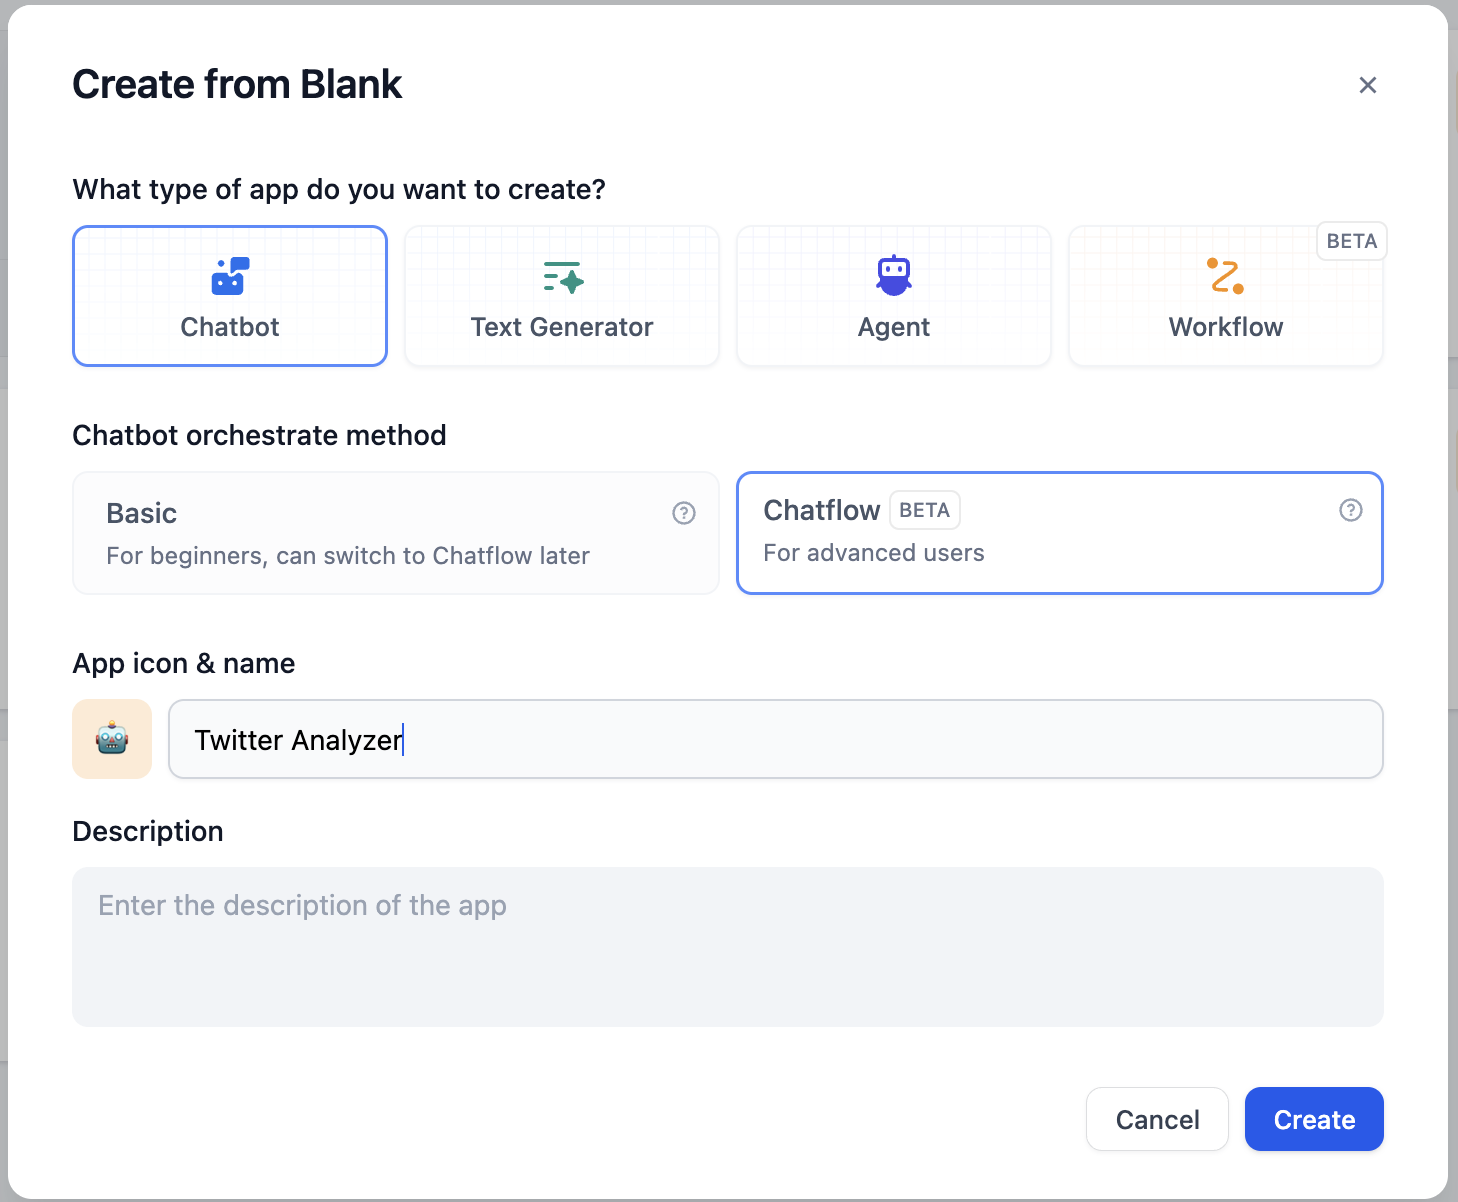
最初から作成をクリックして、新しいフローの作成を開始します:
初期化された Chatflow は以下のようになります:
Chatflow にノードを追加#

開始ノード#
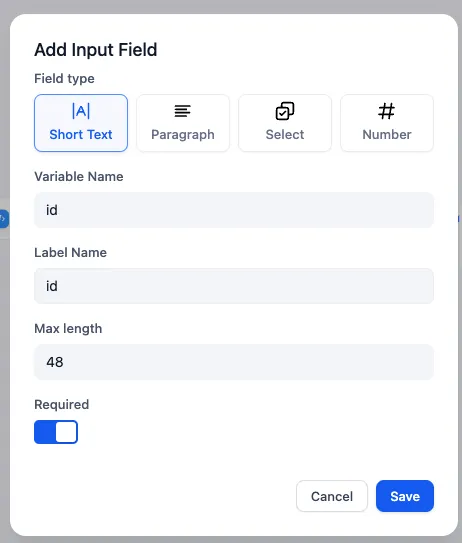
開始ノードでは、チャットの最初にシステム変数を追加できます。このプロセスでは、Twitter ユーザーの ID を文字列型の変数として使用します。変数名をidとしましょう。
開始ノードをクリックして、新しい変数を追加します:
コードノード#
Crawlbase のドキュメントによれば、次のノードで使用する変数urlはhttps://twitter.com/にユーザーIDを加えた形にする必要があります。例えば、Elon Musk のユーザーID の場合はhttps://twitter.com/elonmuskとなります。
ユーザーID を完全な URL に変換するためには、以下の Python コードを使用して、プレフィックスhttps://twitter.com/とユーザーID を結合します:
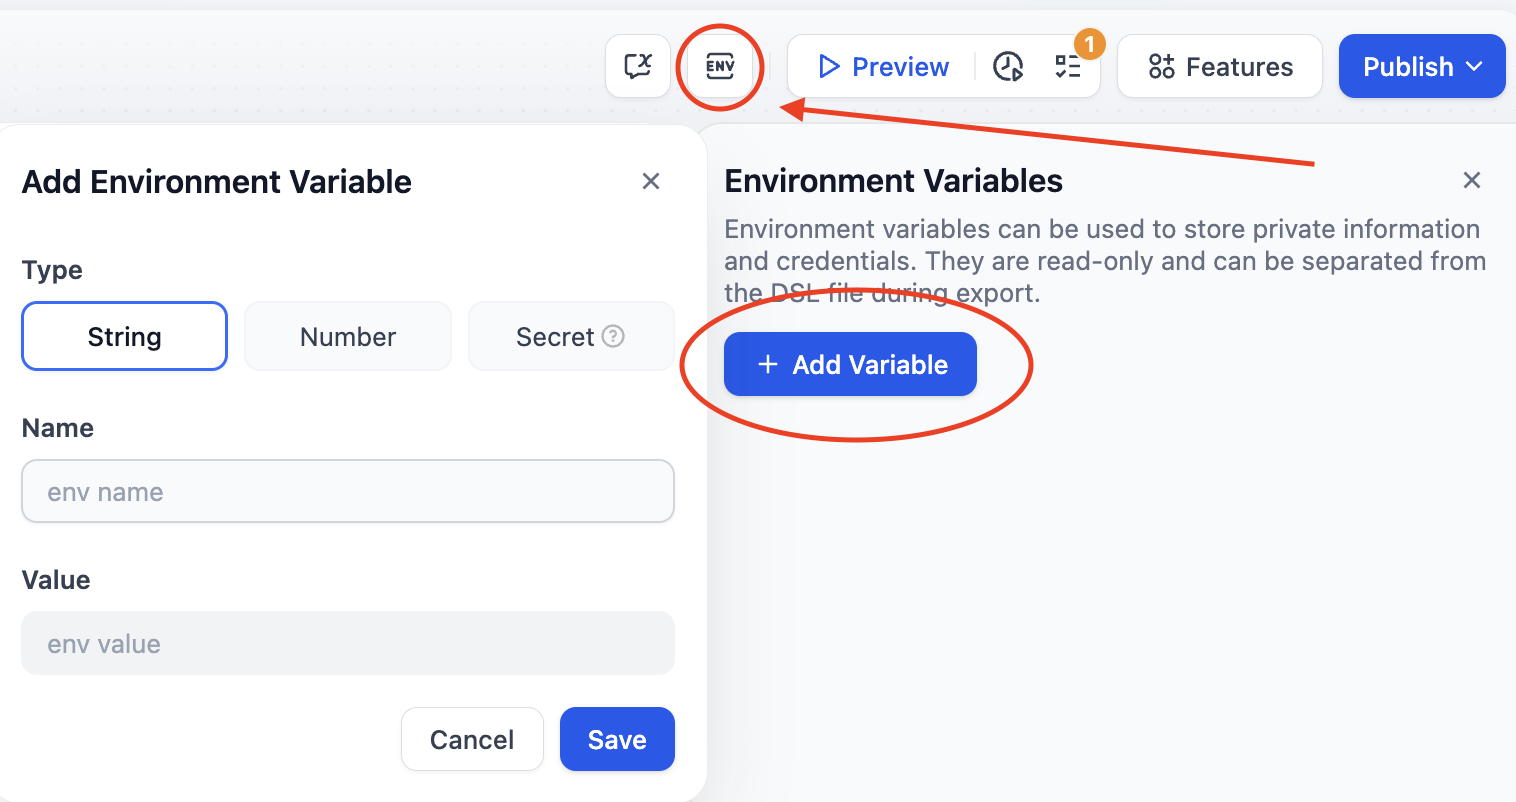
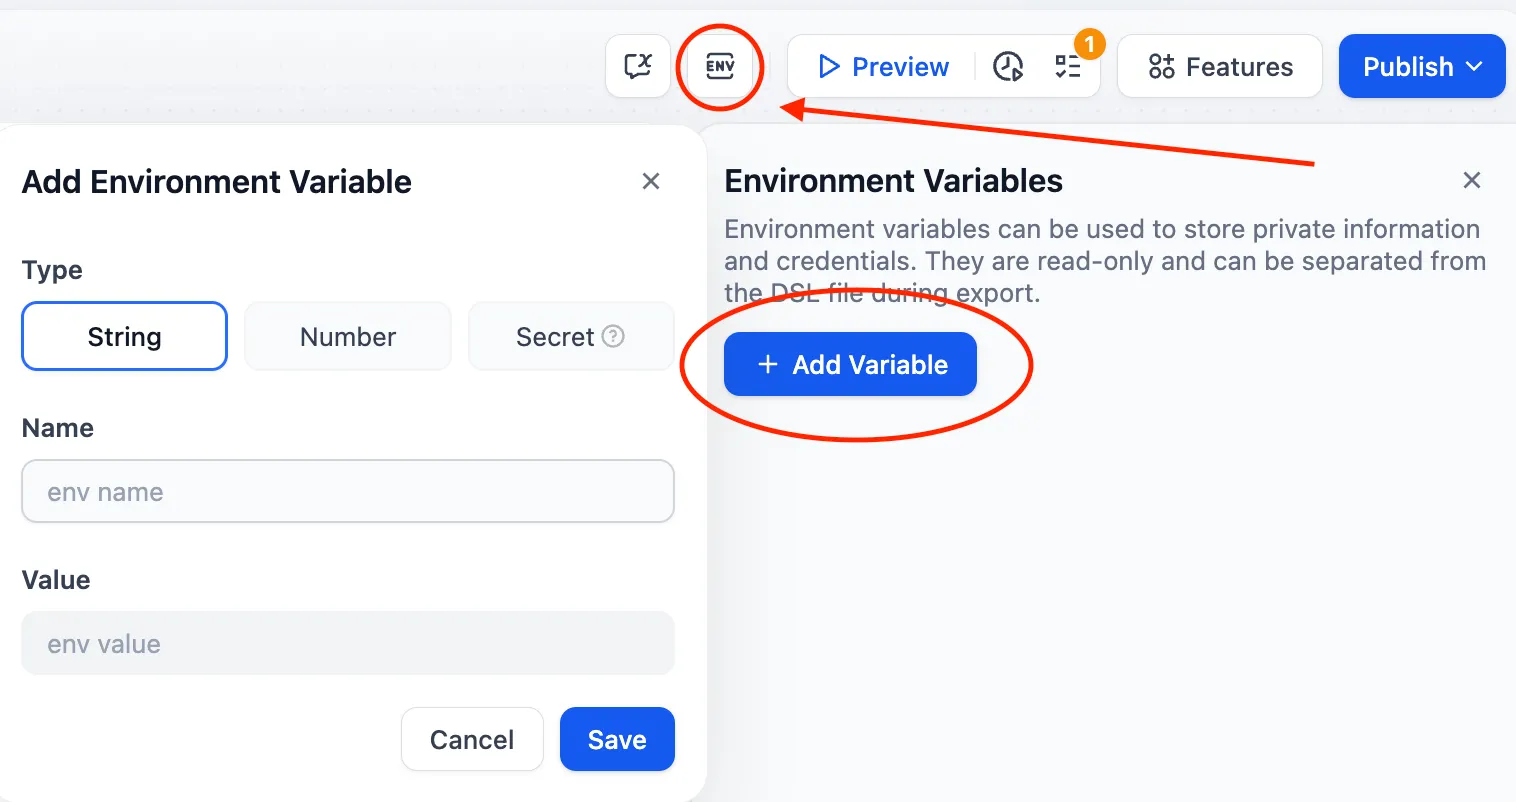
セキュリティ上の観点から、トークン値を平文で直接入力することは避けるべきです。これは推奨されるベストプラクティスではありません。実際、Dify の最新バージョンでは、トークン値を 環境変数 に設定できるようになっています。envをクリックしてAdd Variableを選択し、トークン値を設定すると、ノードに平文が表示されなくなります。
あなたの Crawlbase API キーについては、こちらで確認できます。
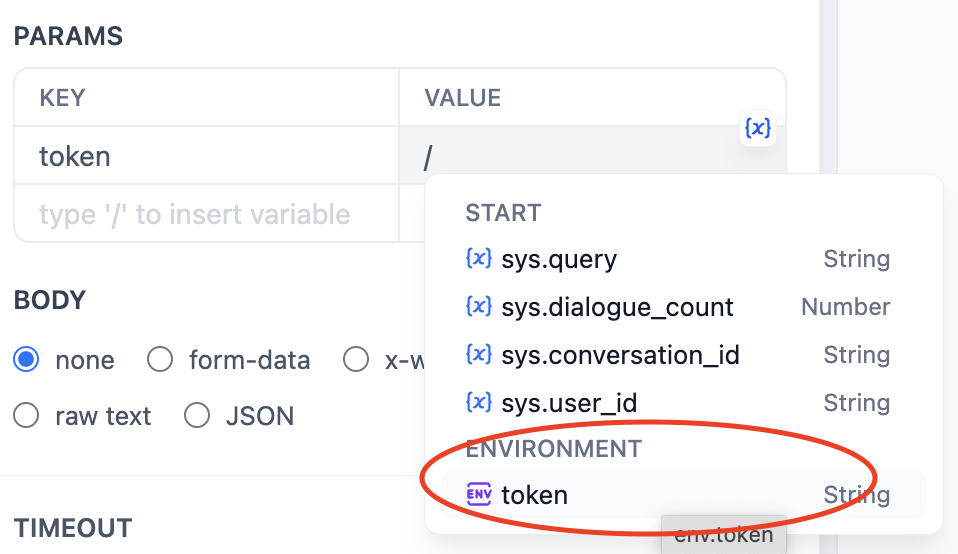
/を入力することで、API キーを簡単に変数として挿入できます。
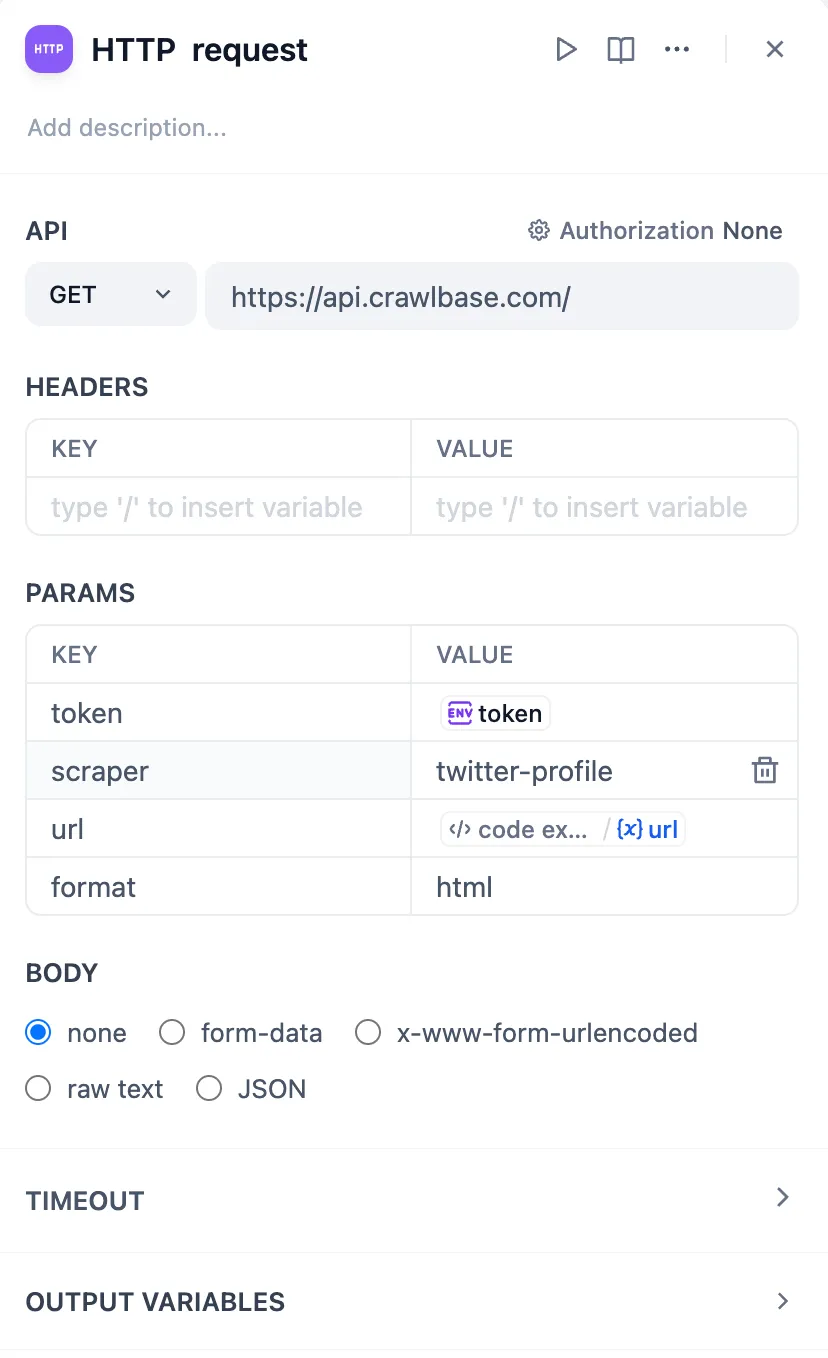
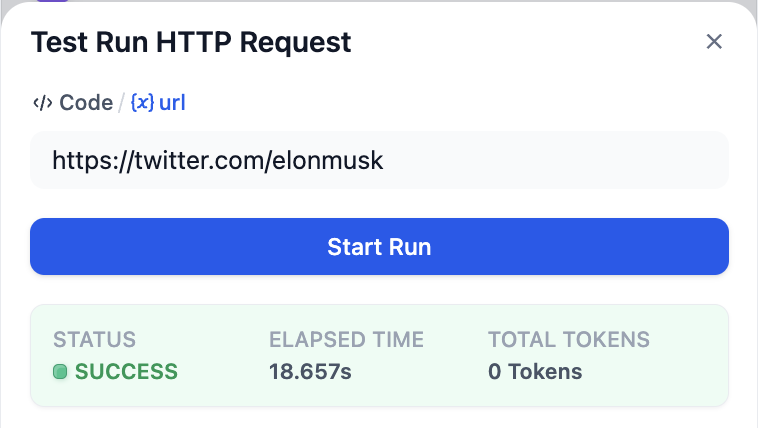
このノードが正しく動作するか確認するために、ノードの開始ボタンをタップしてください:
LLM ノード#
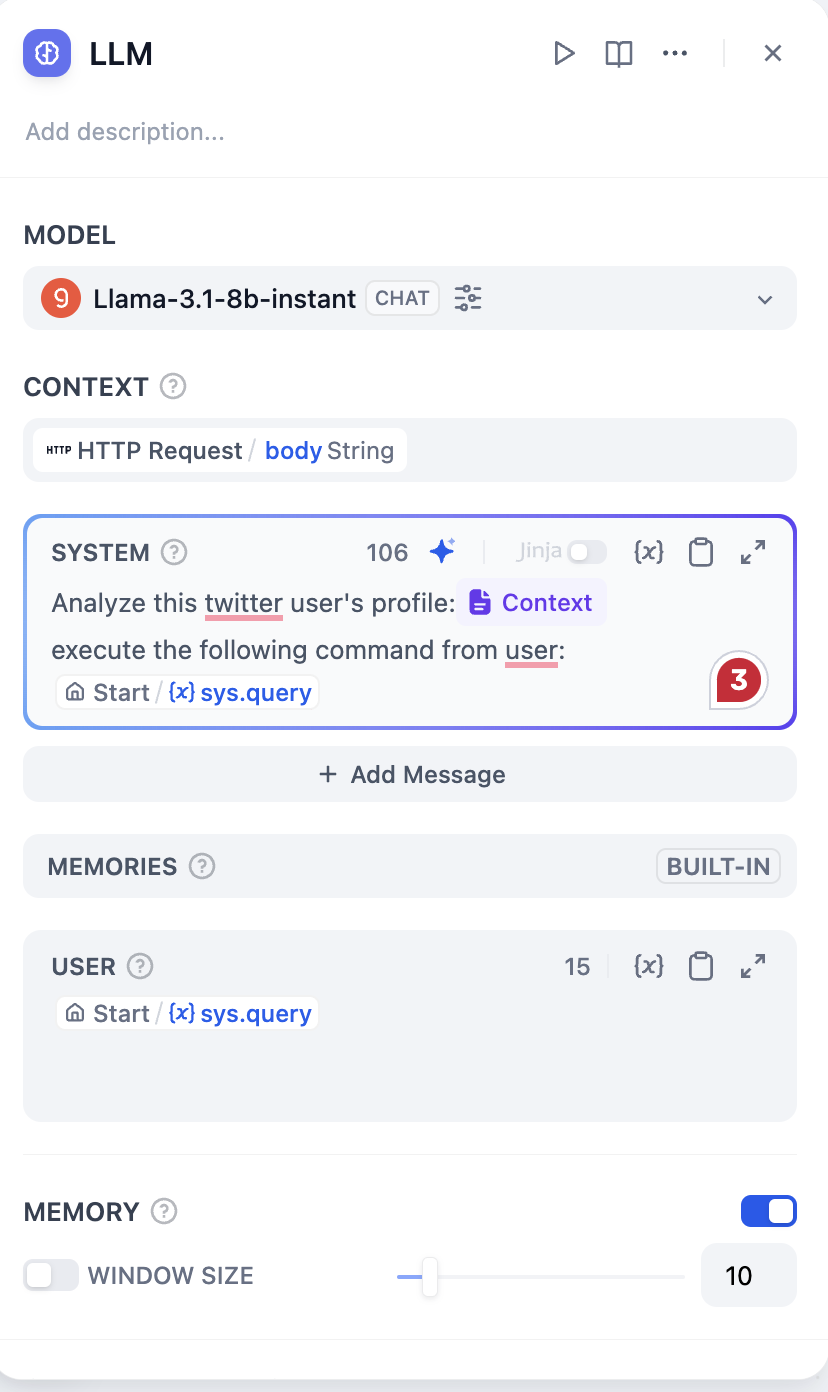
さて、Crawlbase によってスクレイピングされた結果を分析し、コマンドを実行するために LLM を使用できます。
値contextは HTTP リクエストノードからのbodyでなければなりません。
以下はサンプルのシステムプロンプトです。
テスト実行#
プレビューをクリックしてテスト実行を開始し、idに Twitter ユーザーID を入力してください。
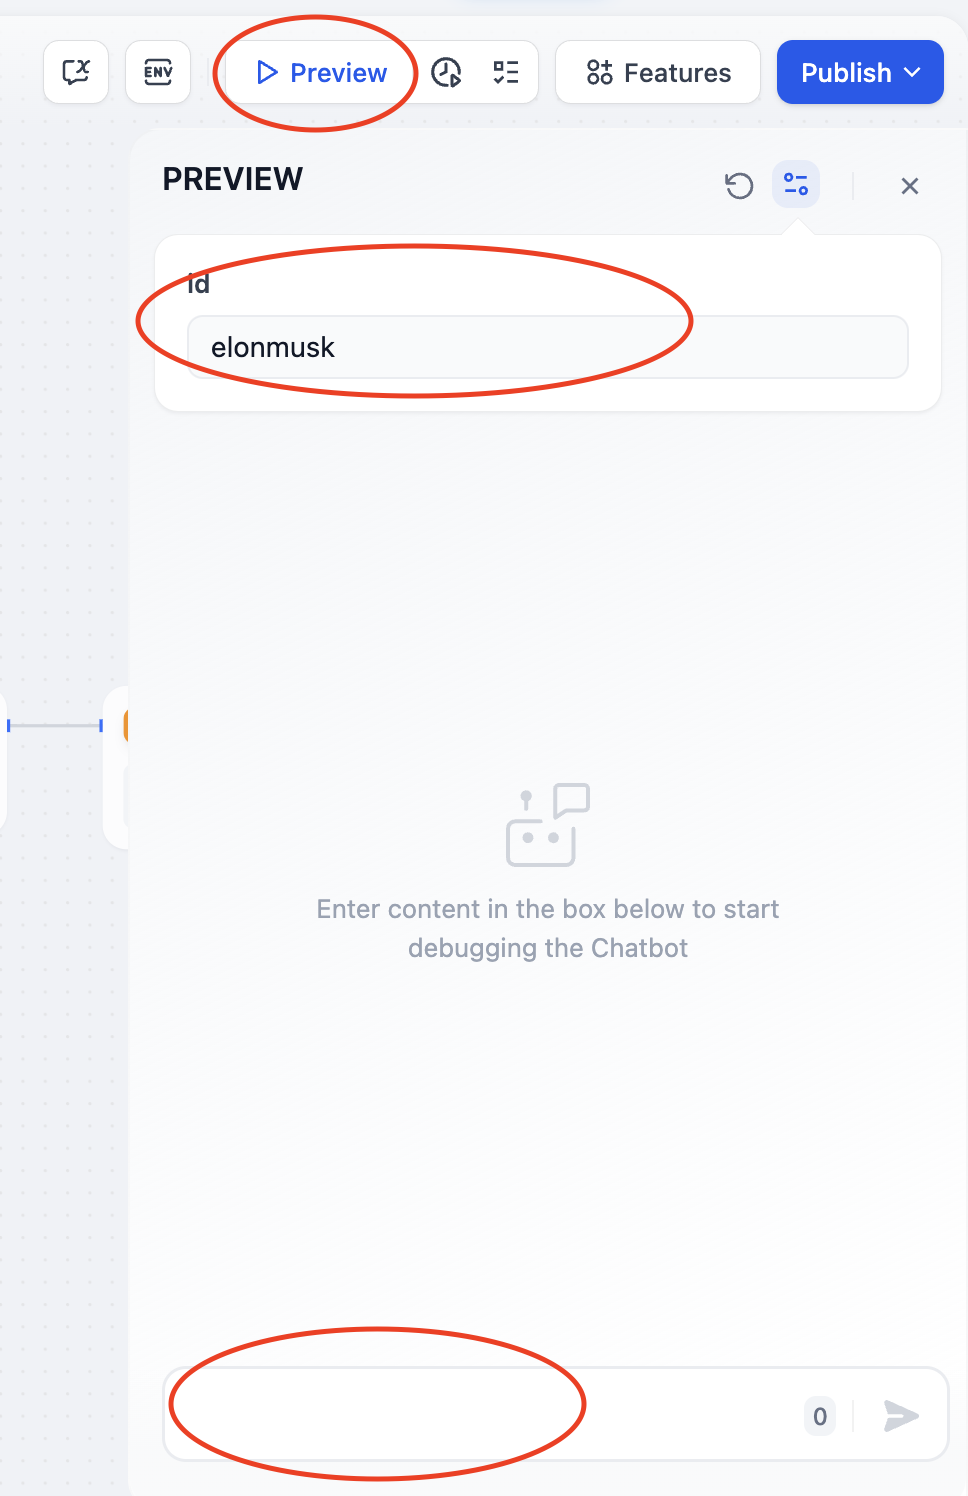
例えば、Elon Musk のツイートを分析し、彼の口調で地球温暖化についてのツイートを書きたいと思います。
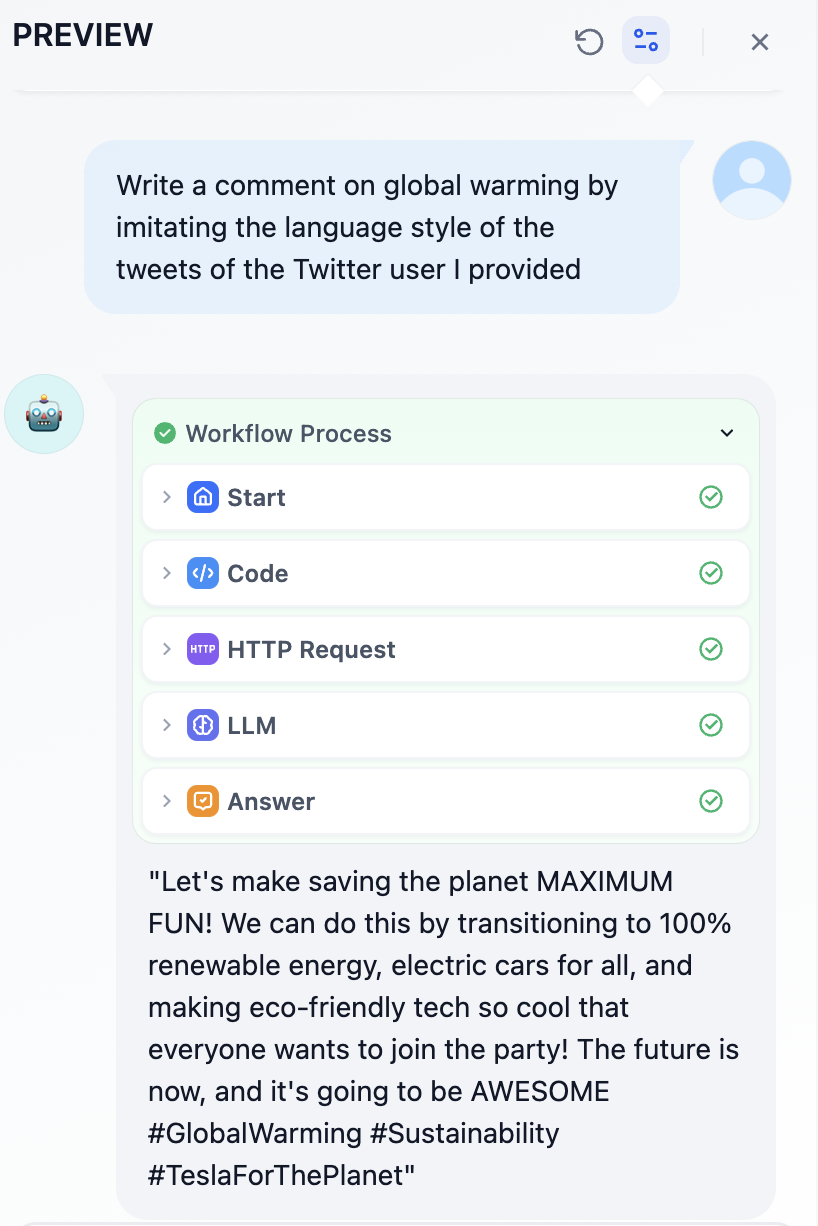
これは Elon らしいですか?笑
右上隅にある公開をクリックして、あなたの Web サイトに追加してください。
楽しんでください!
最後に…#
他の X(Twitter) クローラー#
この記事では、Crawlbase を紹介しました。これはおそらく利用可能な最も安価な Twitter クローラーサービスですが、時々ユーザーのツイートの内容を正しくスクレイピングできないことがあります。
以前に紹介したwordware.aiが使用している Twitter クローラーサービスは Tweet Scraper V2 ですが、ホストされているプラットフォーム apify のサブスクリプションは月額 49 ドルです。
リンク#
- X@dify_ai
- Dify の GitHub リポジトリ:https://github.com/langgenius/dify