

このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、英語版 を参照してください。
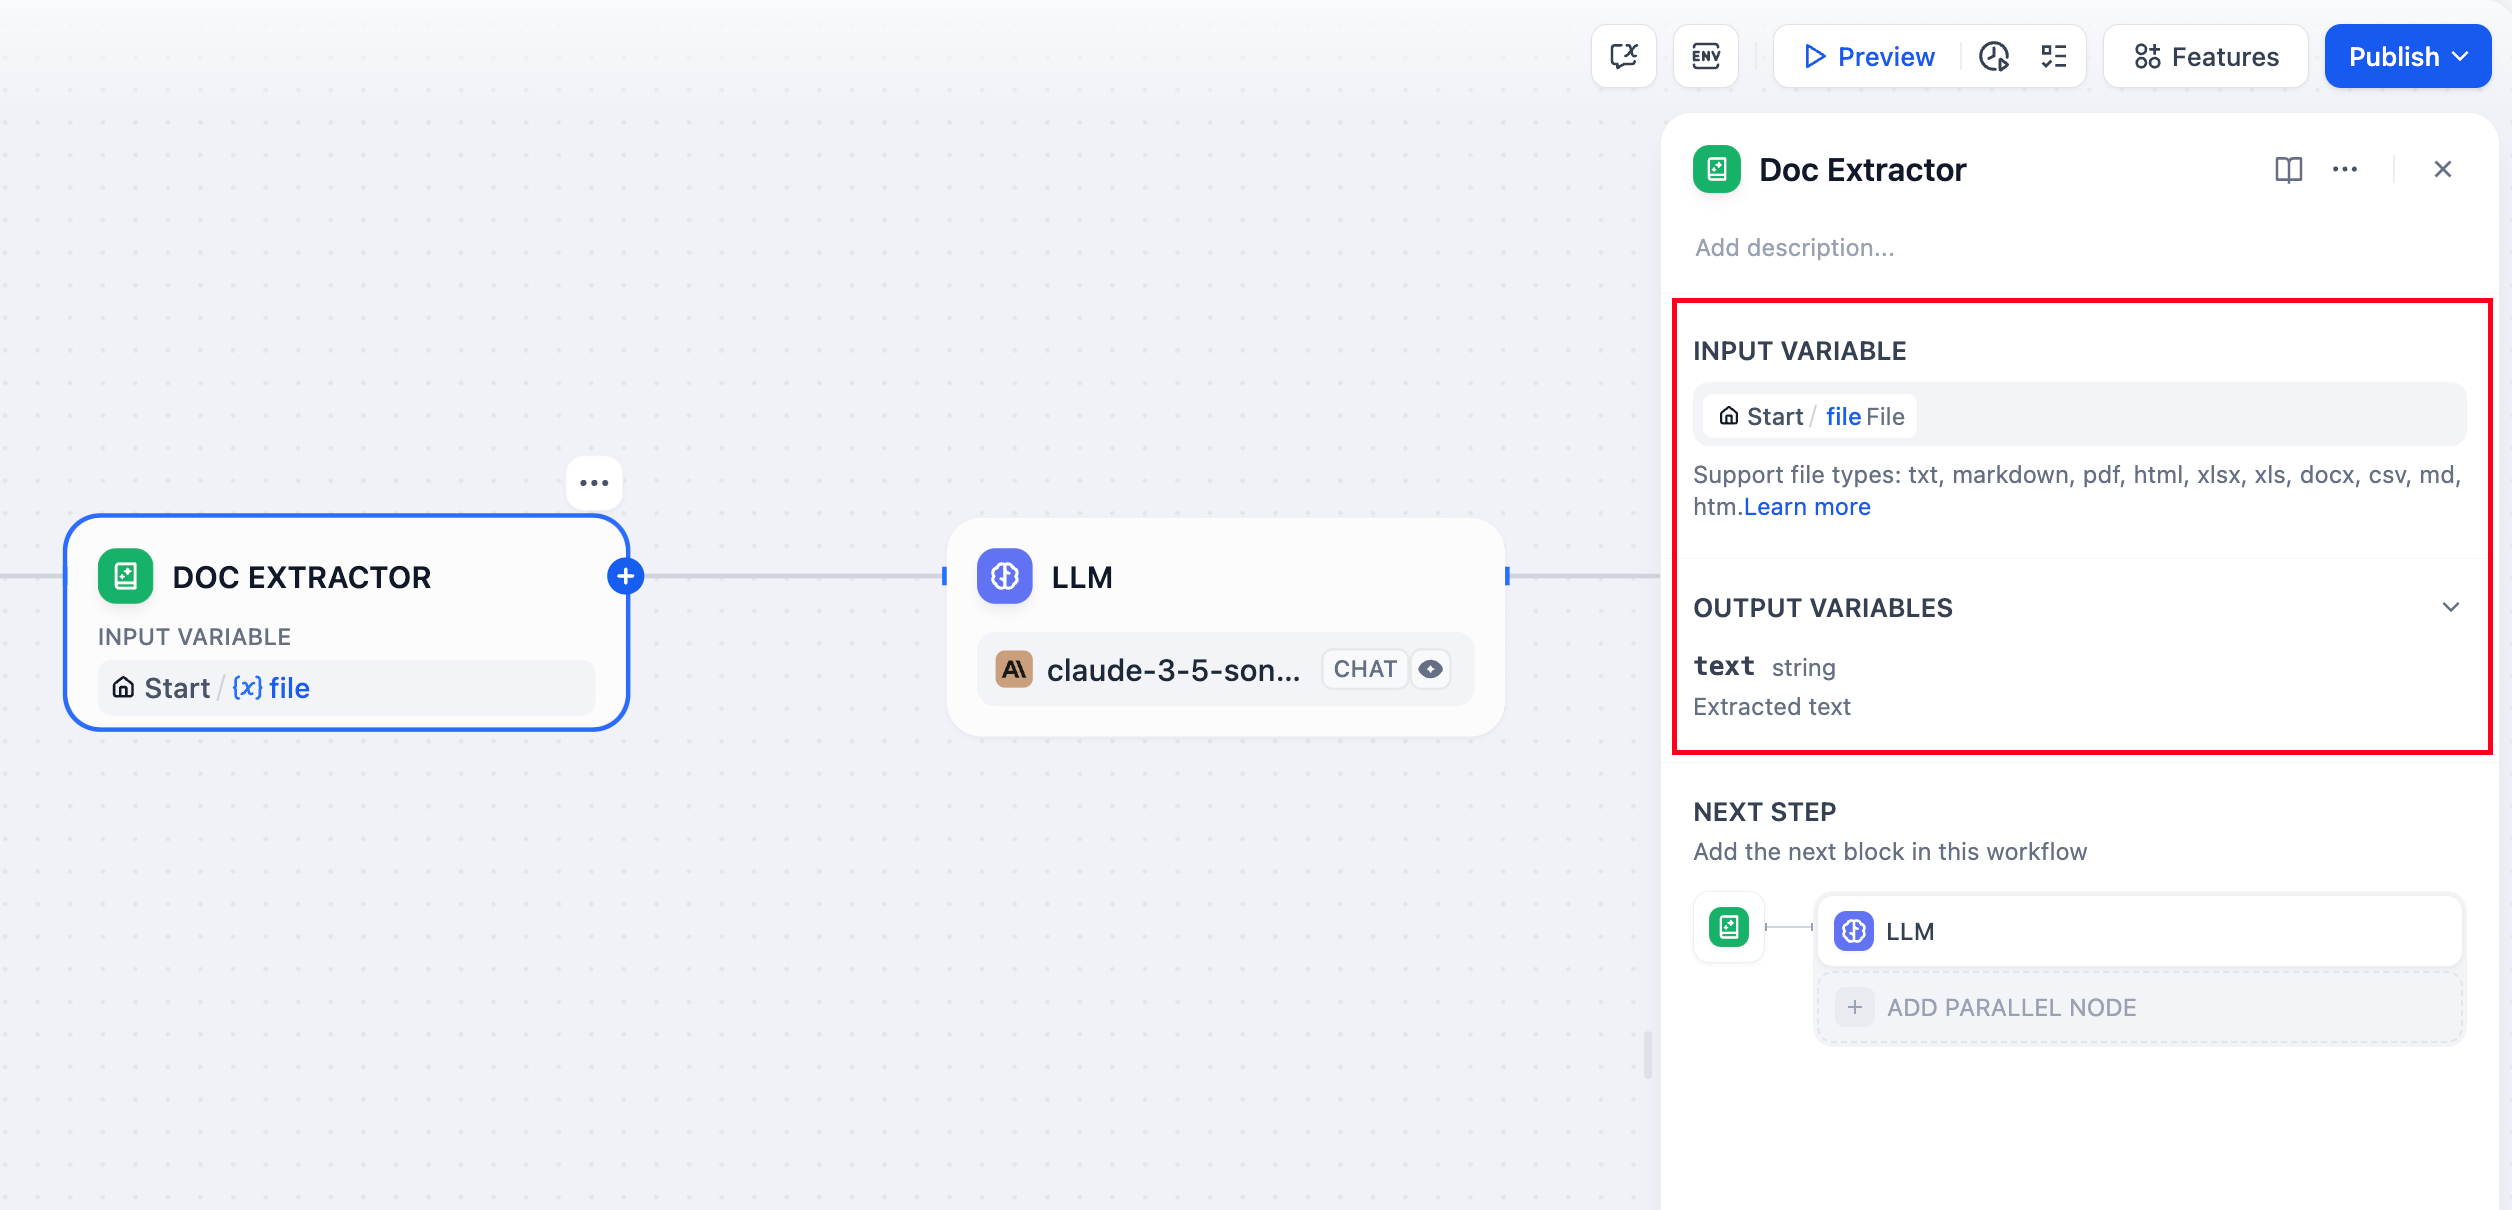
テキスト抽出ノードは、アップロードされたファイルを大規模言語モデルが処理できるテキストに変換します。言語モデルは PDF や DOCX などのドキュメント形式を直接読み取ることができないため、このノードはファイルアップロードと AI 分析の間の重要な橋渡し役を果たします。
サポートされているファイル形式#
このノードは、ほとんどのテキストベースのドキュメント形式を処理できます:
テキストドキュメント - 直接テキストコンテンツを含む TXT、Markdown、HTML ファイル
Office ドキュメント - Microsoft Word および互換アプリケーションの DOCX ファイル
PDF ドキュメント - テキストベースの PDF
Office ファイル - DOCX ファイルは直接解析され、テーブルは Markdown に変換されます。DOC と ODT ファイルにも対応しています。
スプレッドシート - Excel(.xls/.xlsx)および CSV ファイルを Markdown テーブルに変換
プレゼンテーション - PowerPoint(.ppt/.pptx)ファイル
メール形式 - メールコンテンツ抽出のための EML および MSG ファイル
特殊形式 - EPUB 書籍、VTT 字幕、JSON/YAML データ、および Properties ファイル
画像、音声、動画などの主にバイナリコンテンツを含むファイルは、特殊な処理ツールや外部サービスが必要です。
入力と出力#
入力設定#
以下のいずれかを受け入れるようにノードを設定します:
単一ファイル 入力(通常は Start ノードからのファイル変数)
複数ファイル バッチドキュメント処理用の配列として
出力構造#
ノードは抽出されたテキストコンテンツを出力します:
- 単一ファイル入力は抽出されたテキストを含む
stringを生成 - 複数ファイル入力は各ファイルのコンテンツを含む
array[string]を生成
出力変数はtextという名前で、下流処理用の生のテキストコンテンツが含まれています。
実装例#
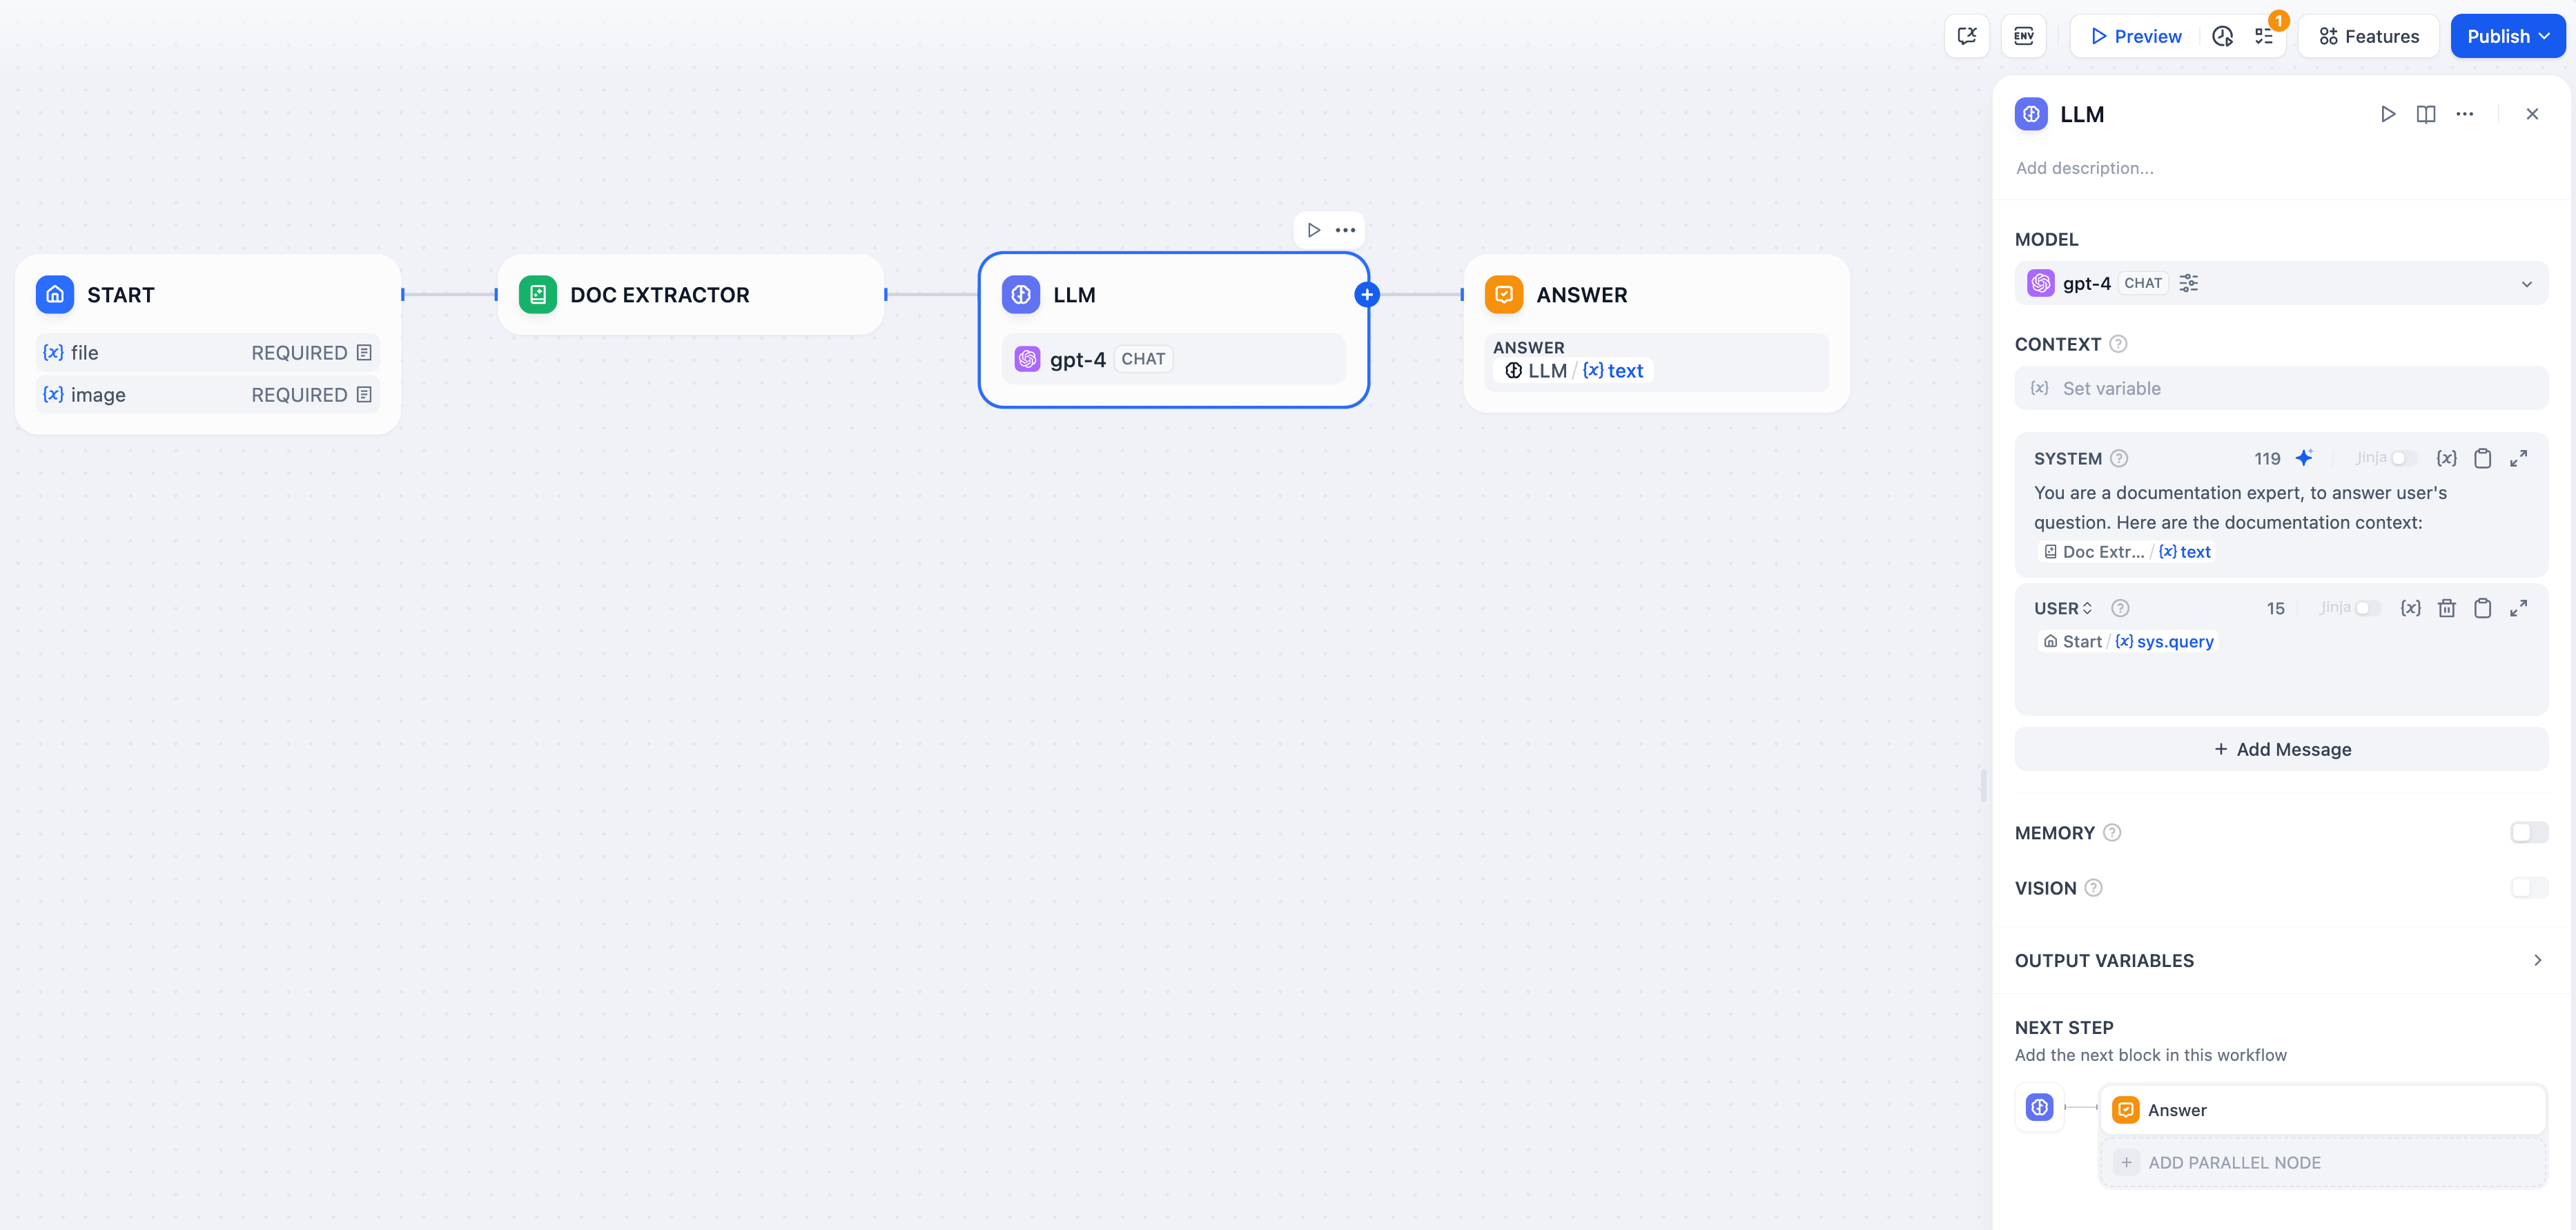
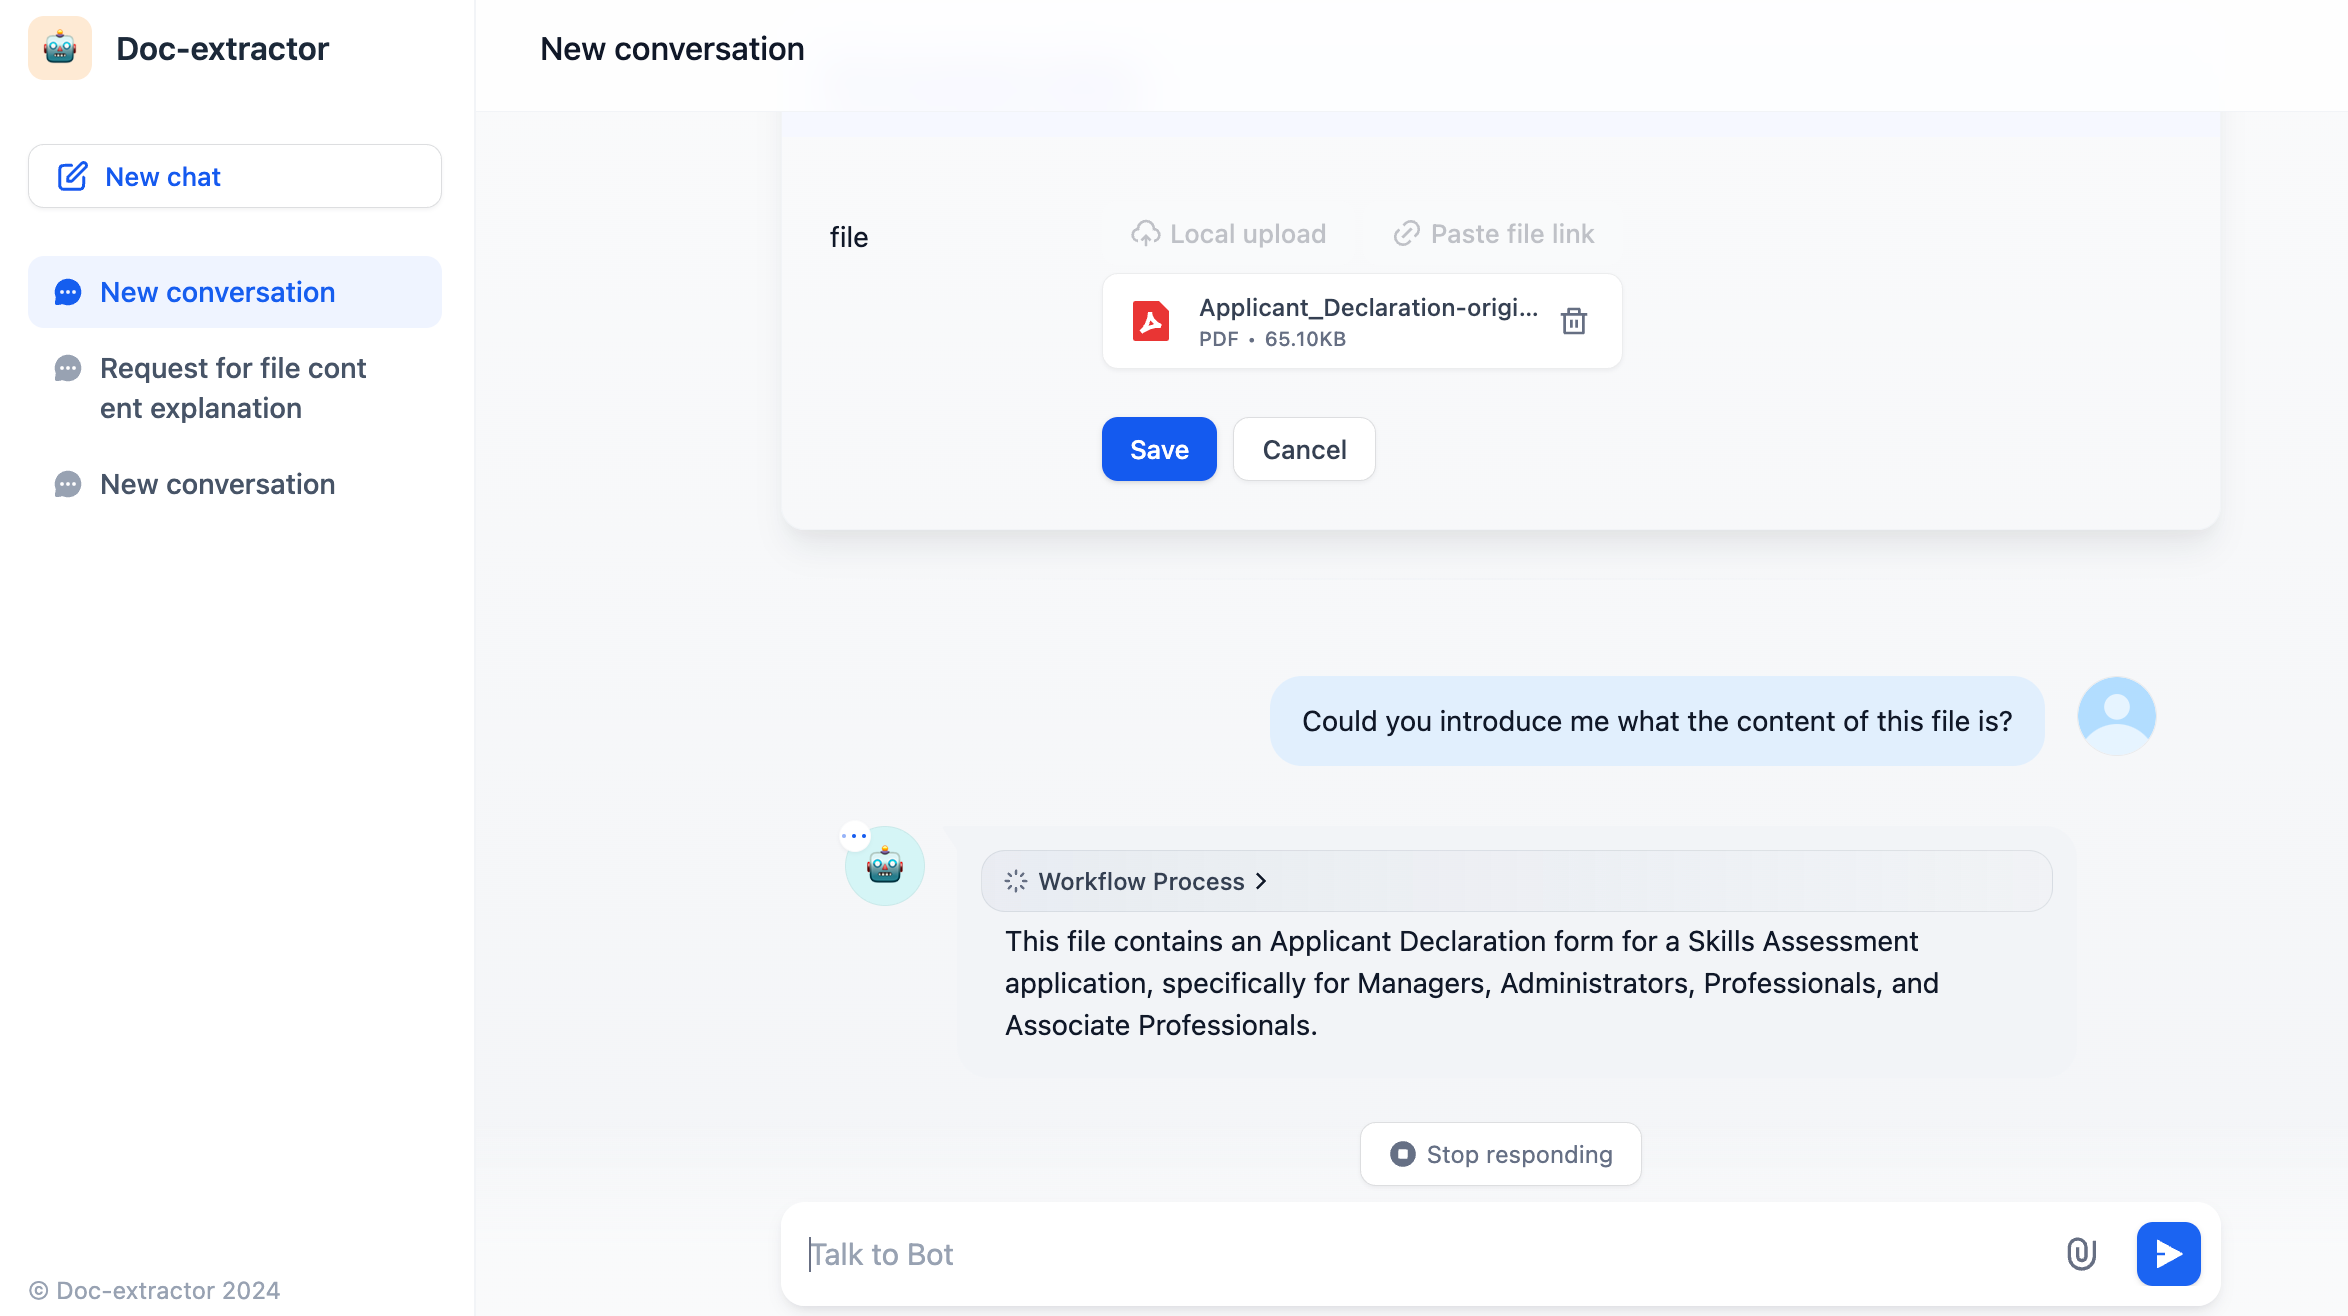
テキスト抽出ノードを使用した完全なドキュメント Q&A ワークフローの例です:
ワークフローセットアップ#
ファイルアップロード設定 - ユーザーからのドキュメントアップロードを受け入れるために、Start ノードでファイル入力を有効にします。
テキスト抽出 - テキスト抽出ノードを接続して、アップロードされたファイルを処理し、テキストコンテンツを抽出します。
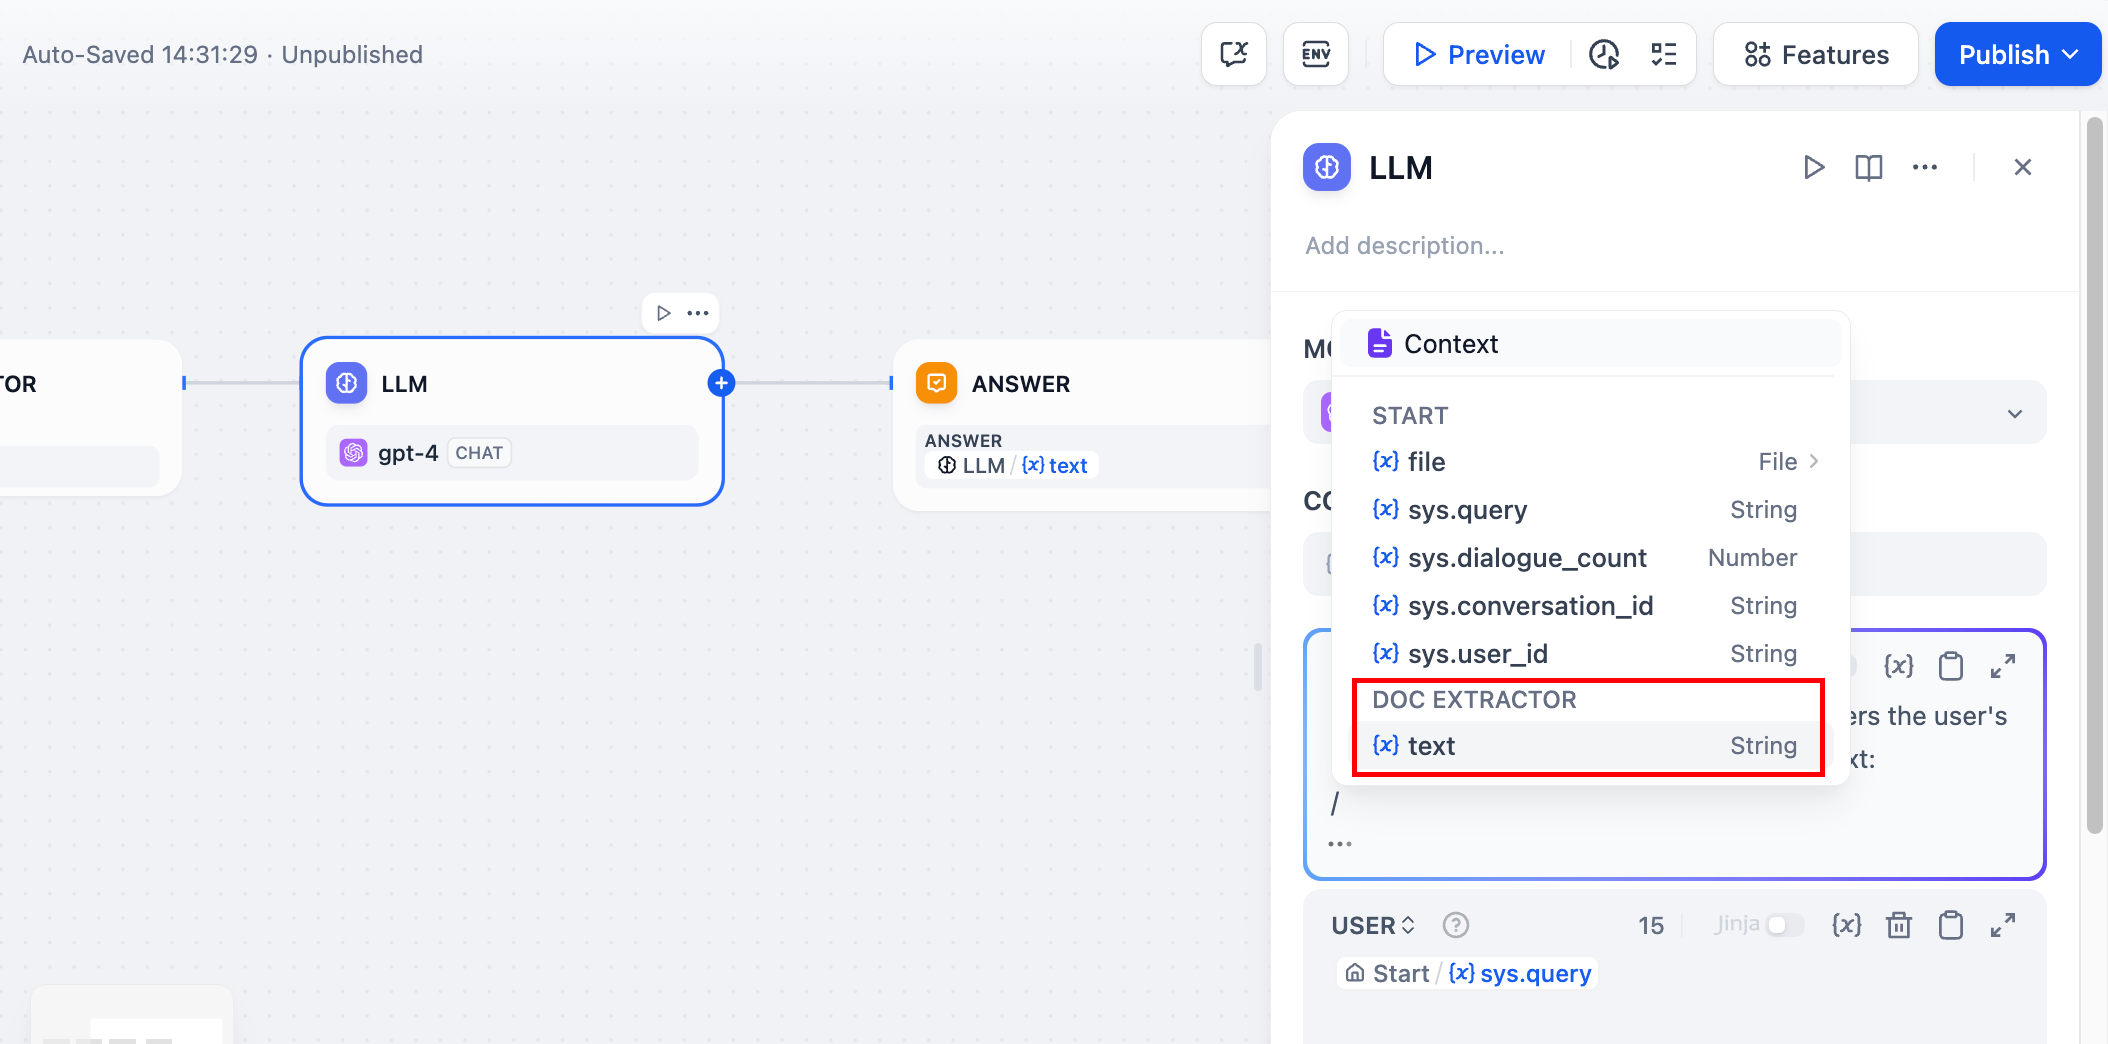
AI 処理 - 抽出されたテキストを大規模言語モデルのプロンプトで分析、要約、または質問応答に使用します。
処理の考慮事項#
テキスト抽出ノードは、異なるファイル形式に最適化された特殊な解析ライブラリを使用します。可能な限りテキスト構造と書式を保持し、抽出されたコンテンツを大規模言語モデル処理により有用にします。
ファイル形式処理#
エンコーディング検出 - chardet ライブラリを使用してファイルエンコーディングを自動検出し、テキストベースファイルの UTF-8 フォールバック
テーブル変換 - Excel と CSV データを Markdown テーブルに変換してより良い大規模言語モデル理解を実現
ドキュメント構造 - DOCX ファイルは適切なテーブル-Markdown 変換により段落とテーブルの順序を維持
複数行コンテンツ - VTT 字幕ファイルは同一話者による連続した発話を結合
非常に大きなドキュメントの場合は、大規模言語モデルのコンテキスト制限を考慮し、必要に応じて分段戦略を実装してください。抽出されたテキストは、意味とコンテキストを保持するために元のドキュメントの論理構造を維持します。