

このドキュメントは AI によって自動翻訳されています。不正確な部分がある場合は、英語版 を参照してください。
次のようなメールが届いたとしましょう:
こんにちは!Dify って何ですか?あと、どのモデルに対応していますか?無料プランはありますか?
このメールをそのまま今の AI アシスタントに送ると、最初の質問にしか答えなかったり、すべての質問に対して曖昧な回答をしてしまう可能性があります。
まず、すべての質問を特定し、ナレッジベースを使って一つずつ回答する方法が必要です。
パラメータ抽出#
パラメータ抽出は、非常に優秀な情報収集員のようなものです。テキスト(メールなど)を読み込み、指定された情報を見つけ出して、整理されたリストにまとめます。
ハンズオン 1:パラメータ抽出ノードを追加する#
メールアシスタントをアップグレードする前に、以下のノードを削除しましょう:ナレッジ検索、If/Else、LLM、LLM 2、変数アグリゲーター。
ノードを追加する
開始ノードの直後に、パラメータ抽出 ノードを追加します。
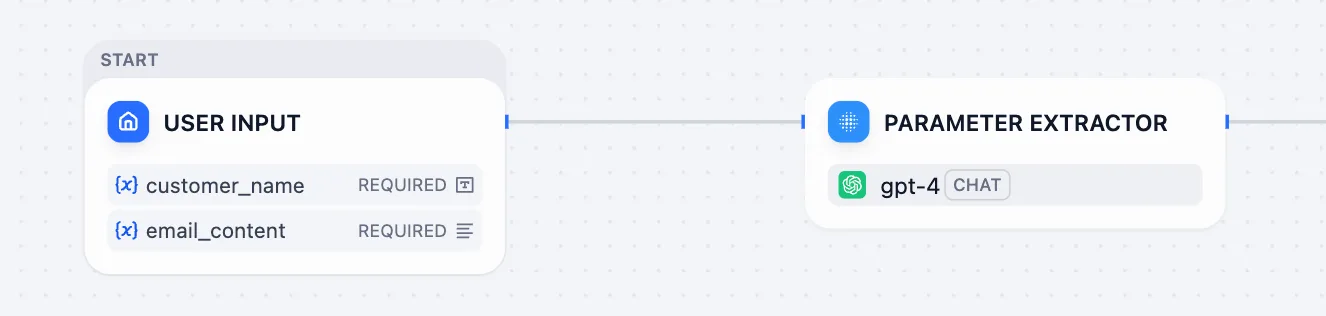
入力を設定する
パラメータ抽出をクリックし、右側パネルの 入力変数 セクションで email_content を選択します。
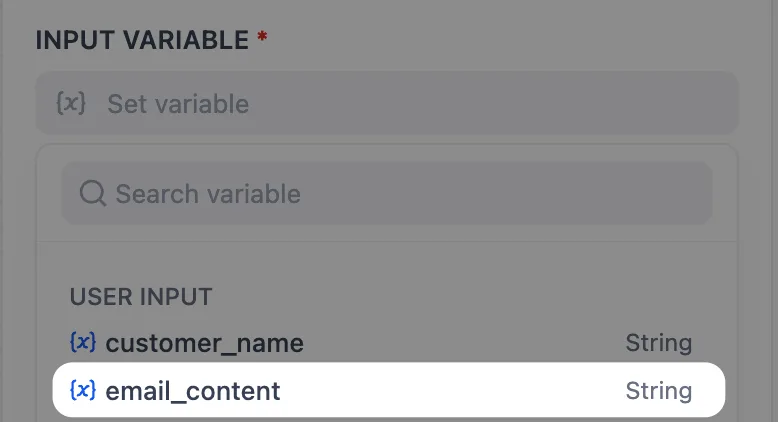
AI はメールからどの情報を抽出すべきか自動的にはわからないため、すべての質問を収集するよう明示的に指示する必要があります。
抽出パラメータを追加する
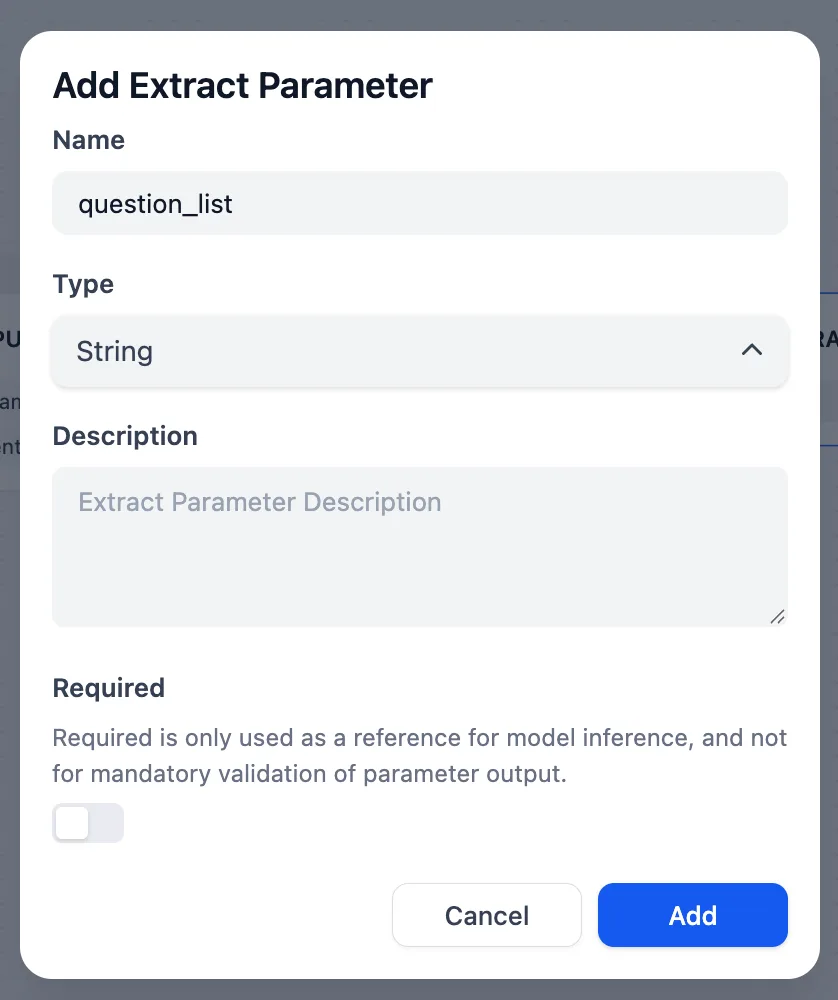
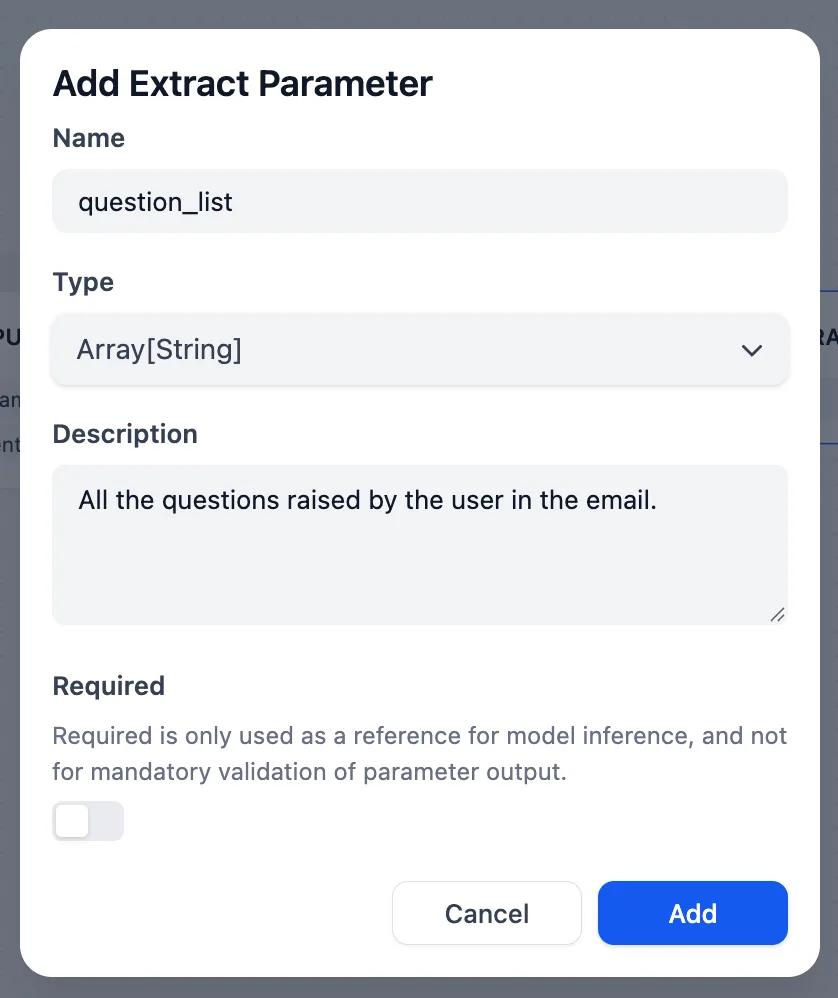
抽出パラメータ の横にあるプラス(+) アイコンをクリックして、AI が探すべき内容の定義を始めます。名前は question_list とします。
パラメータの型
パラメータ抽出が情報収集員だとすると、型は情報を入れるための「かご」です。正しい情報には正しいかごが必要です。
単一項目(小さなかご)
- String(テキスト):単一のテキスト情報用。例:顧客名
- Number(数値):単一の数値用。例:注文数量
- Boolean(ブール値):はい/いいえ(True/False)のシンプルな判定。判定結果や意思決定に適しています
リスト項目(配列)
- Array[String]:Array はリスト、String はテキストを意味します。つまり
Array[String]は、複数のテキストを格納できるかごです。例えば、メール内の個別の質問すべてを格納できます - Array[Number]:複数の数値を格納するためのコンテナです。例:価格リストや商品リスト
- Array[Boolean]:複数のはい/いいえの判定結果を格納します。例えば、複数のタスクを含むリストをチェックし、各項目が完了しているかどうかを返します。
[Yes, No, Yes]のようになります - Array[Object]:複数のデータセットを格納する高度なフォルダです(例:名前と電話番号を含む連絡先リスト)
抽出パラメータの追加を完了する
- 必要に応じて、メール内容には
Array[String]を選択します。 - 補足情報として説明を追加します。例:ユーザーがメール内で提起したすべての質問。入力後、追加 をクリックします。
指示を追加する
抽出パラメータの下にある 指示 ボックスに、AI への明確なコマンドを入力します。
例:メールからすべての質問を抽出し、各質問をリストの個別の項目としてください。
これにより、このノードはメール内のすべての質問を見つけられるようになります。情報収集員が情報を集め終えたので、次のステップに進みましょう。AI に各質問を処理させる方法を設定します。
イテレーション#
イテレーションを使うと、アシスタントに分身のチームがいるようなものです。リスト(メール内の質問リストなど)を渡すと、リストの各項目に対して分身が一人ずつ現れます。
各分身は割り当てられた項目を受け取り、まったく同じタスクを実行するため、漏れが発生しません。
ハンズオン 2:イテレーションノードを設定する#
ノードを追加する
- パラメータ抽出の後にイテレーションノードを追加します。
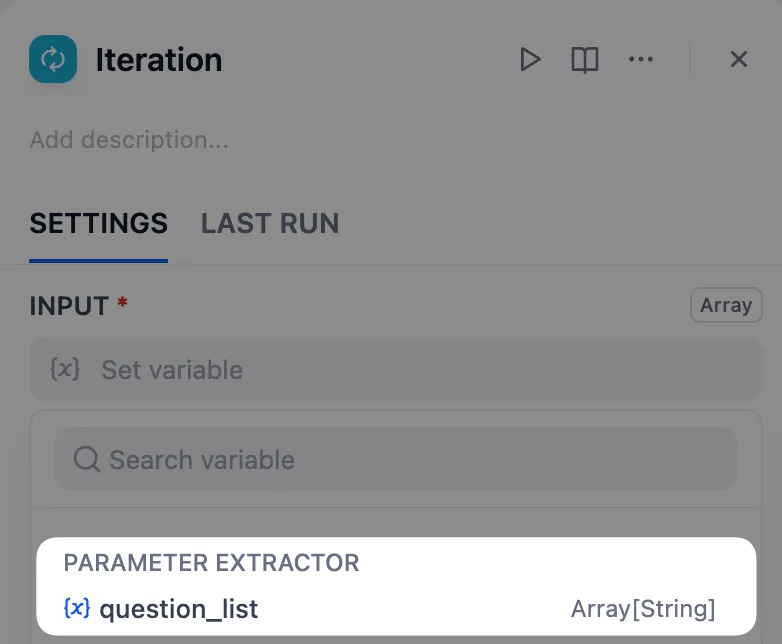
- イテレーションノードをクリックし、右側の入力パネルに移動します。
- パラメータ抽出から
{x} question_listを選択します。出力変数は今は空白のままにしておきます。
イテレーションの高度なオプション
イテレーションパネルには、さらに多くの設定があります。簡単に見ていきましょう。
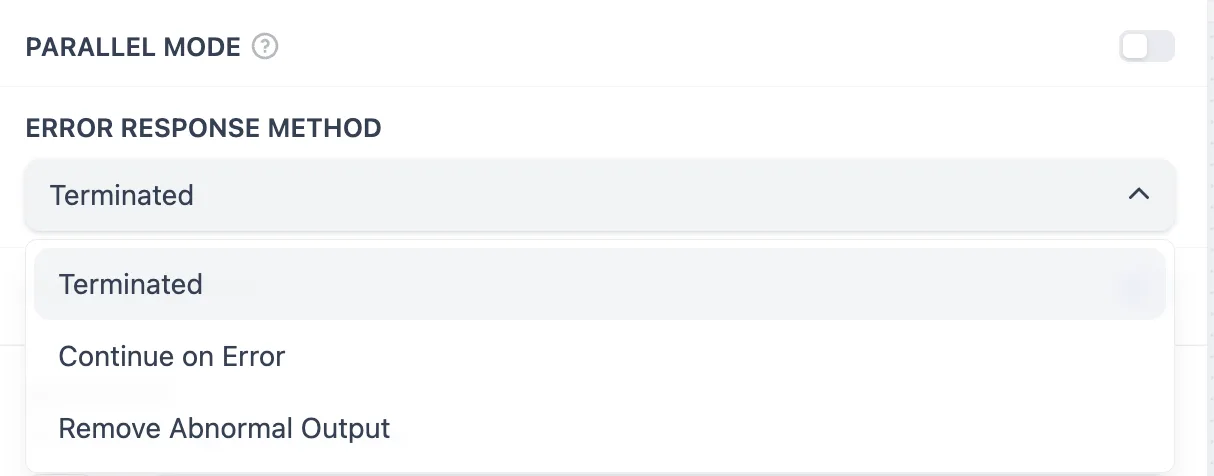
並列モード:OFF(デフォルト)
- 無効の場合、ワークフローはリストの各項目を順番に処理します(質問 1 を完了してから質問 2 へ)。
- 有効にすると、ワークフローはリストのすべての項目を同時に処理しようとします(5 人のシェフが同時に 5 つの料理を作るイメージです)。
エラー応答方法:デフォルトはエラー時に終了。
- 終了:リストのいずれかの項目(例:2 番目の質問)がサブプロセスで失敗すると、ワークフロー全体が直ちに停止します
- エラーを無視して続行:2 番目の質問が失敗しても、ワークフローはそれをスキップして残りの質問の処理を続けます
- 異常な出力を削除:無視と同様ですが、最終出力リストの結果からその失敗した項目も削除します
ワークフローに戻ると、イテレーションノードの下にサブプロセスエリアが表示されます。このボックス内のすべてのノードは、各質問に対して一度ずつ実行されます。
ナレッジ検索ノードを追加する
- イテレーションボックスの中に、ナレッジ検索ノードを追加します。
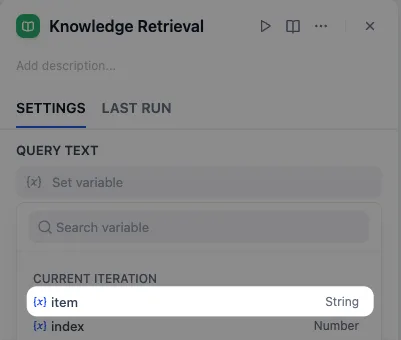
- クエリテキストを
{x} itemに設定します。イテレーションでは、item は常に現在処理中の質問を指します。
LLM ノードを追加する
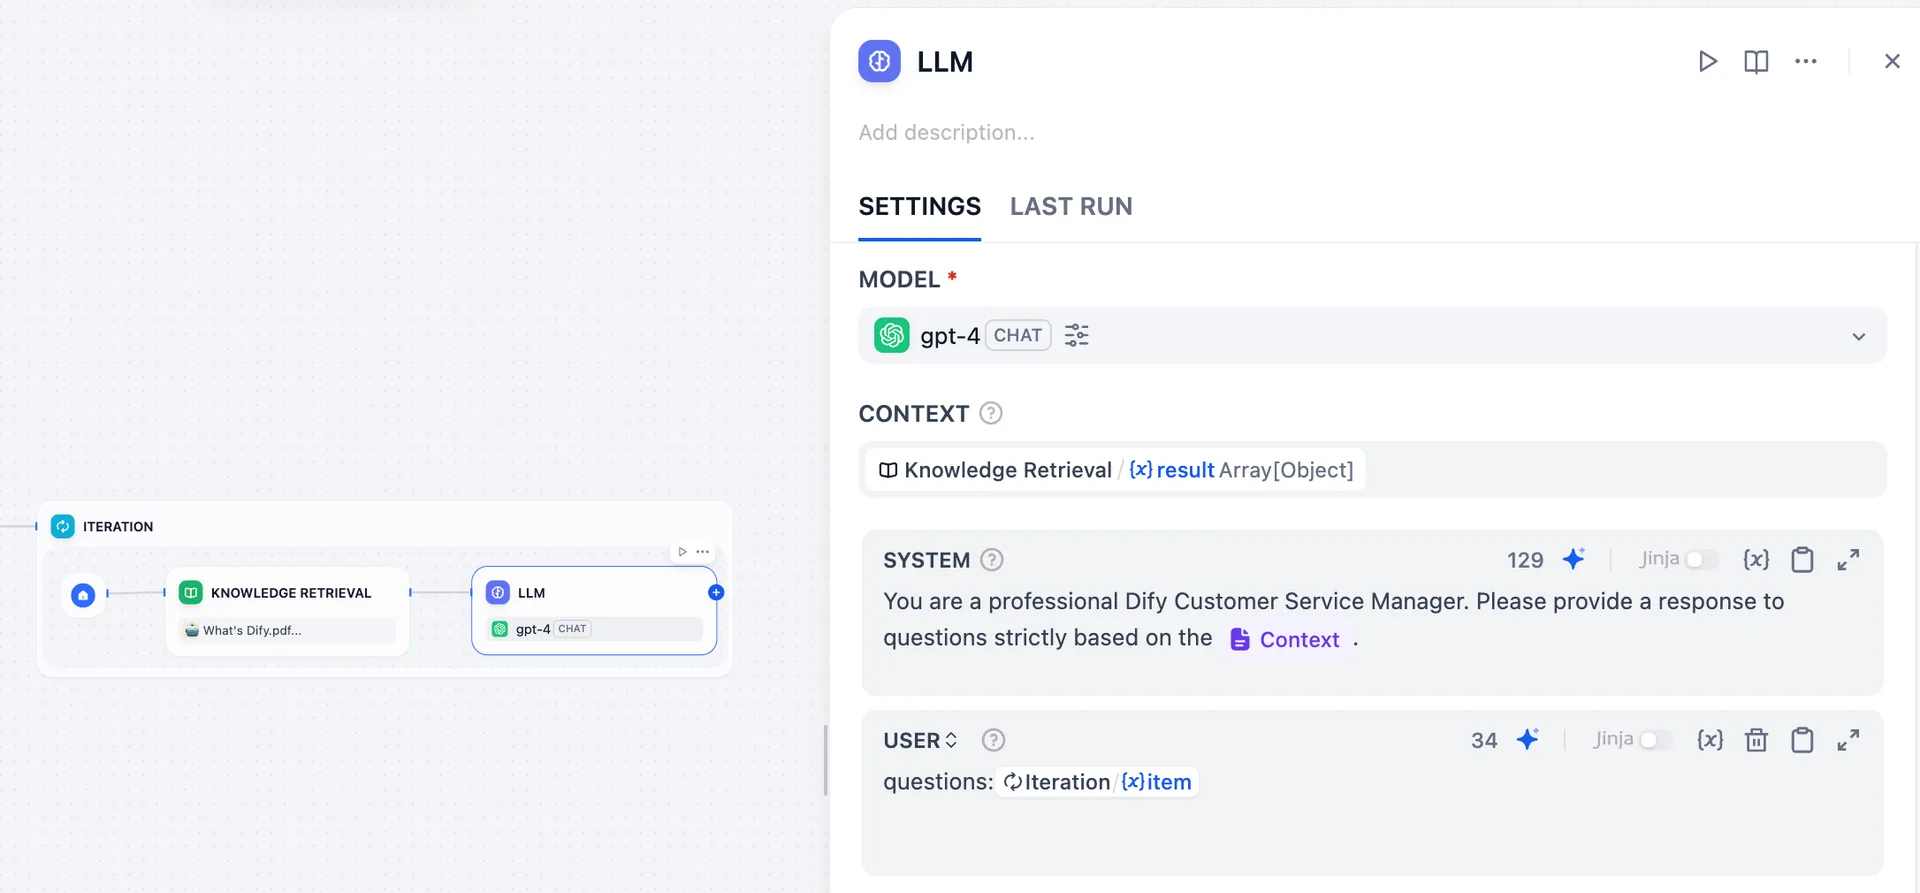
- ナレッジ検索の後に LLM ノードを追加します。
- 検索されたコンテキストに基づいて質問に回答するよう設定します。
レッスン 4 を覚えていますか?あのプロンプトスキルを活用し、コンテキストを忘れないでください!
以下のプロンプトを参考にしてください:
System:
User:
イテレーションノードは各質問に対して個別の回答を生成するため、これらの回答をすべて集めて 1 つの完全な返信メールを作成する必要があります。
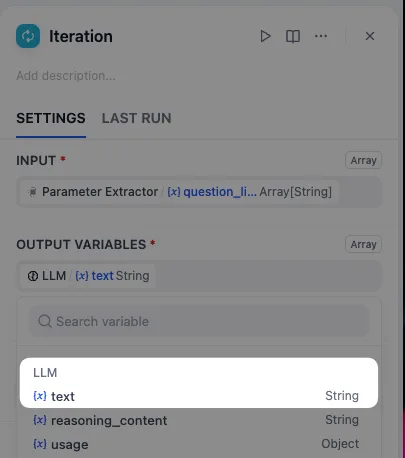
イテレーションの出力を設定する
- イテレーションノードをクリックします。
- 出力変数 で、ループ内の LLM の回答を表す変数を選択します。これにより、イテレーションノードはすべての回答を収集し、新しいリストにまとめます。
最終 LLM ノードを追加する
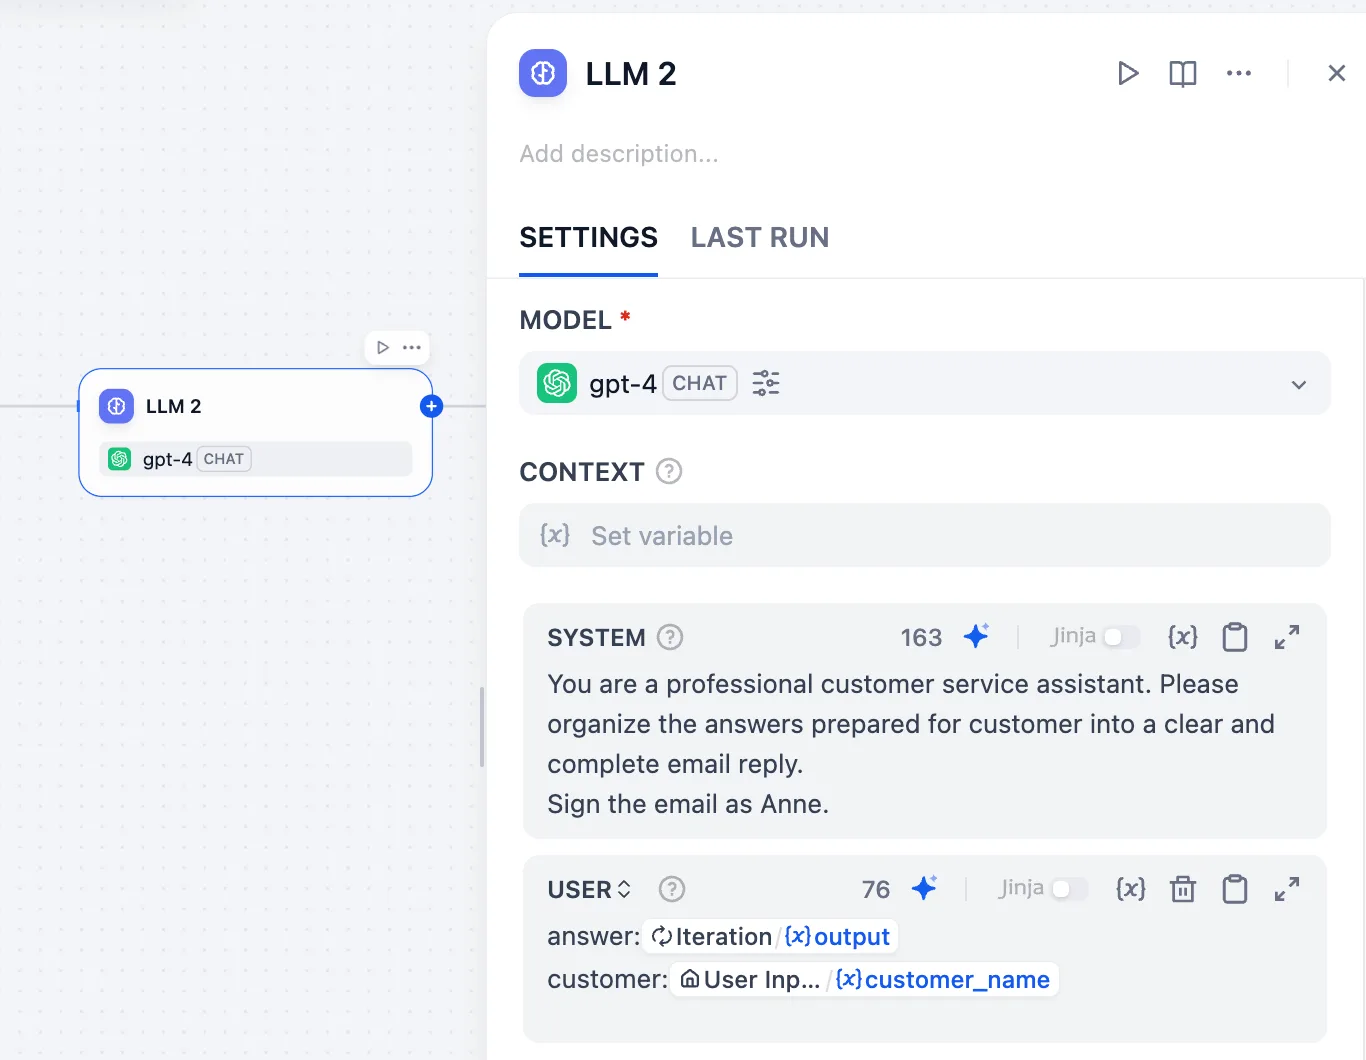
最後に、もう 1 つ LLM ノードを接続します。この最終ノードが、収集されたすべての回答をまとめて、1 通のプロフェッショナルなメールに仕上げます。
System とユーザーメッセージにプロンプトを追加することを忘れないでください。以下のプロンプトを参考にしてください。
User:
最終チェック
- チェックリストをクリックして、漏れがないか確認します。注意事項に従い、出力ノードを接続し、無効な変数の問題を修正する必要があります。
- 出力ノードを手前の LLM 2 ノードに接続し、以前の変数を削除してから、LLM 2 の text を出力変数として選択します。
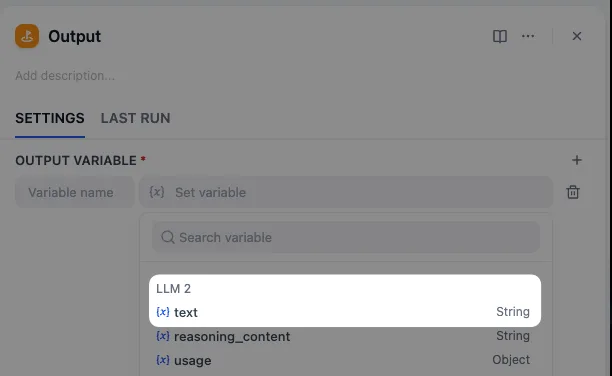
これで、3 つの異なる質問を含むテストメールを作成し、生成された返信を確認してみましょう。
ミニチャレンジ#
パラメータ抽出は他にどんな情報を見つけられるでしょうか?
パラメータ抽出のパラメータ型を探索してみてください。